Supermemory
知识库Supermemory 是面向智能体的记忆引擎,通过 API、插件或 MCP 接入任意模型,把对话与文件沉淀为可更新记忆库并实时注入上下文,适合跨会话记住用户的 AI 产品。
记忆层向量图谱持续学习
月访问量66.4 万↓12.0%
全球排名#56,196
月访问量为第三方平台估算,仅供参考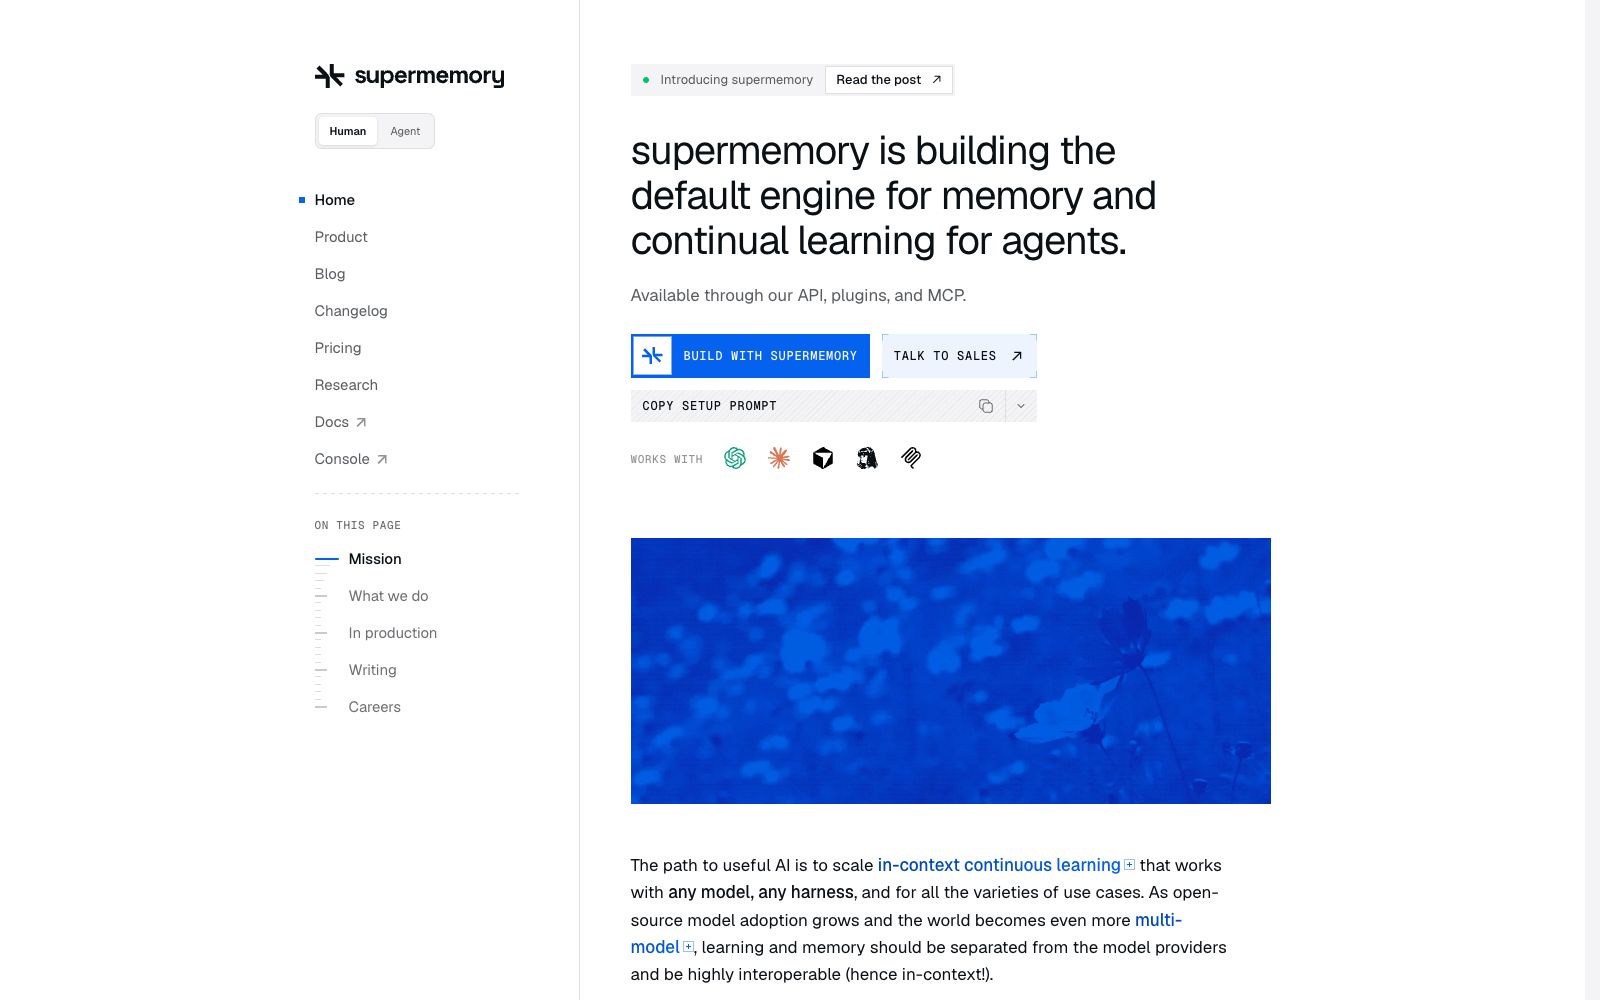
Deep Dive
更新于 2026-11-03详细介绍
Supermemory 想解决的是智能体的失忆问题:模型再强,也不会在一次对话结束后记住你的偏好。它把记忆做成独立于模型的一层基础设施,通过 API、插件与 MCP 接入,任何模型、任何调用框架都能用。与把历史记录直接塞进提示词的做法相比,它会对记忆做更新、合并、推断与遗忘,再按需注入。
核心能力
- learner-1 记忆模型:官方称它会从用户、任务与租户的上下文中抽取信息,写入向量图数据库,并支持更新、合并、推断与遗忘。
- 实时上下文注入:通过钩子把相关记忆以 token 形式注入模型上下文,不需要改动模型本身。
- 跨模型通用:记忆存放在模型供应商之外,换模型或换框架都能带走。
- 多入口接入:提供 API、插件与 MCP,官方称可在多种助手中直接配置。
- 部署形态灵活:支持部署在自有数据中心、私有网络、笔记本电脑,甚至完全隔离的气隙环境。
- 合规与安全:官方称通过 SOC 2 认证、符合 HIPAA 与 GDPR,可签署数据处理协议。
- 性能数据:官网披露检索服务端 187 毫秒、端到端 356 毫秒;已服务 10 万多家组织,月处理超一万亿 token。
适合谁
- 做 AI 助手产品的工程团队:需要跨会话记住用户偏好与历史决定。
- 客服与销售类智能体开发者:要让机器人记住客户背景与上次结论。
- 多模型混用的团队:不想把记忆绑死在某一家模型厂商。
- 有数据合规要求的行业:医疗、金融等需要私有化或气隙部署的场景。
- 研究长上下文与记忆机制的团队:可参考其公开基准与论文。
使用建议
- 先用官方提供的一键配置提示词接入现有助手,跑通写入、检索、注入再谈调优。
- 记忆不是越多越好,明确哪些信息值得长期保留,避免上下文被无关内容挤占。
- 检索延迟与成本随记忆规模增长,上线前用真实流量压测,而不是只看演示数据。
- 免费层适合验证,正式使用按用量计费,具体价格与额度以官网定价页为准。
- 涉及个人数据时提前设计删除与遗忘路径,并确认部署区域满足合规要求。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Supermemory 近一个月流量下降 12.0%,月访问量约 66.4 万,在「知识库」40 个同类工具中排第 6 位。全球排名第 56,196 位(前 10 万)。
月访问量
66.4万
较上月 -12.0%较3月前 -23.6%
跳出率
45.4%
只看一页就离开,越低越好
平均时长
01:58
每次访问的平均停留
次均页数
3.16页
每次访问浏览的页面数
近 12 个月当月 66.4 万
81.9 万
70.9 万
43.1 万
48.6 万
88.9 万
96.8 万
88.1 万
60.5 万
86.9 万
88.2 万
75.4 万
66.4 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 美国44.8%
- 印度16.4%
- 印度尼西亚4.4%
- 意大利4.0%
- 德国3.1%
流量来源
访客从哪里进来- 直接访问49.2%
- 搜索引擎30.0%
- 社交媒体12.5%
- 外链引荐5.7%
- 展示广告0.3%
- 邮件0.3%
- 其他2.1%
「知识库」内排名高于中位数 540%
第6名
共 40 个同类工具
本工具
66.4 万
中位数
10.4 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考