
FlagEval天秤
其他智源研究院的大模型评测体系与开放平台,官方称覆盖语言、多模态、计算机视觉与语音四类评测场景,提供排行榜、大模型角斗场与自动加人工结合的评测方法与工具集。
大模型评测评测基准开源工具
月访问量1.0 万↓36.3%
月访问量为第三方平台估算,仅供参考界面预览
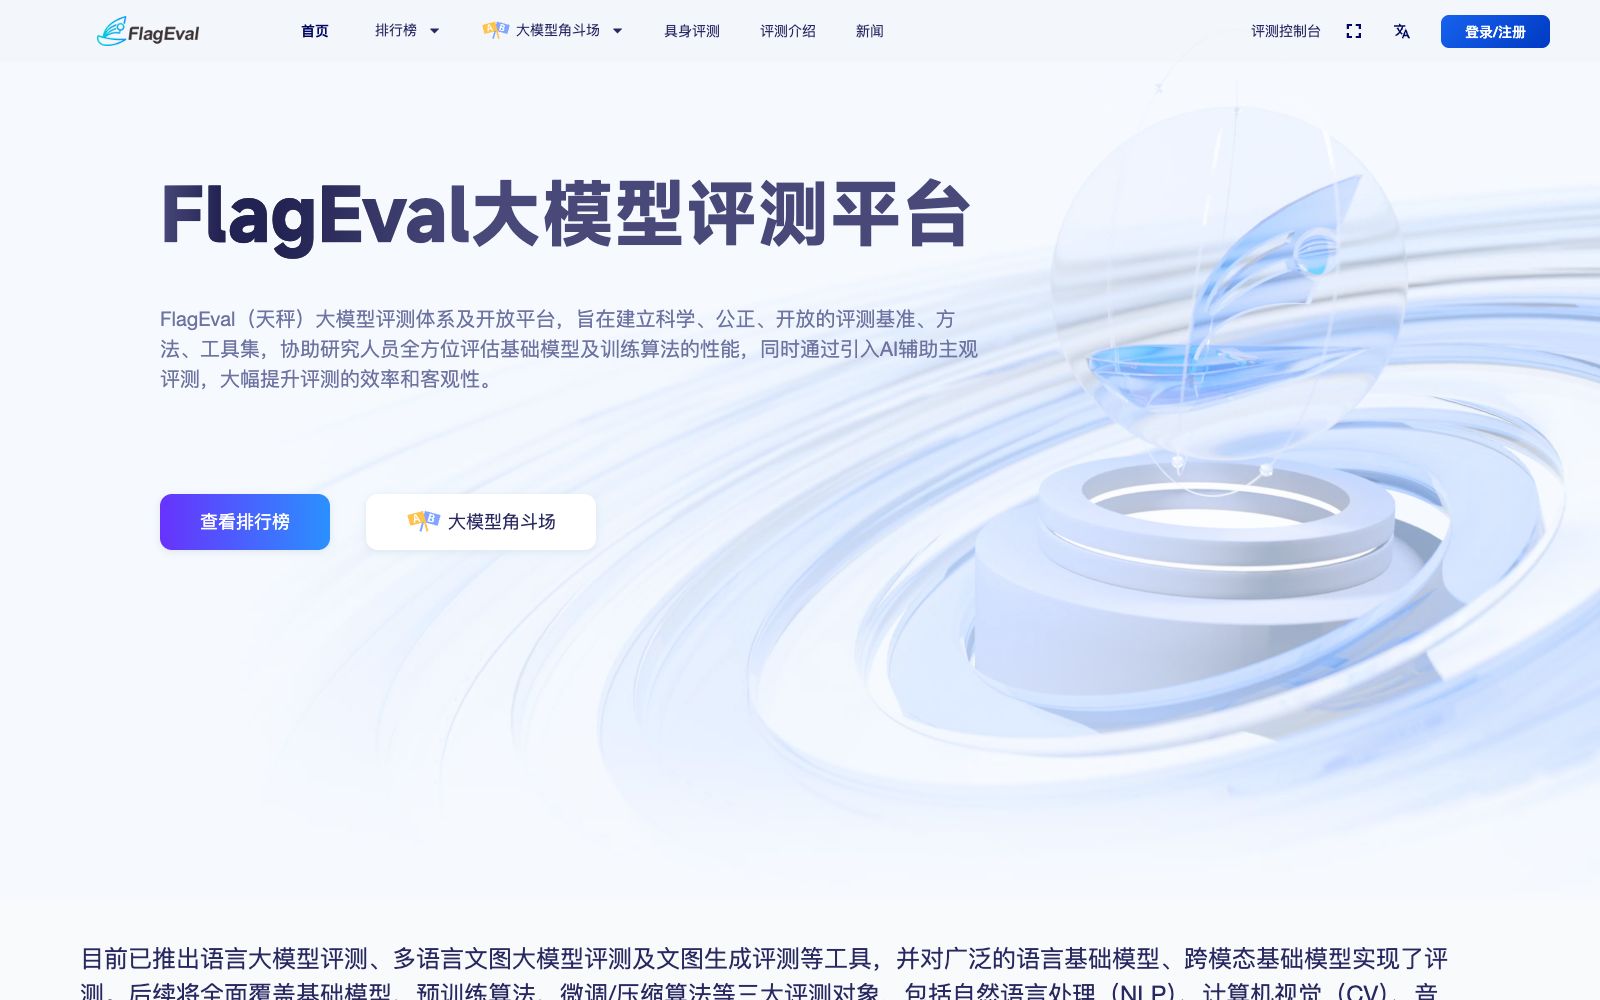
Deep Dive
更新于 2026-11-04详细介绍
快速了解
核心摘要- 是什么
- 智源研究院推出的大模型评测体系及开放平台,提供排行榜与角斗场两个入口
- 核心能力
- 语言大模型评测、多模态大模型评测、计算机视觉评测、语音评测、大模型角斗场
- 使用方式
- 开放平台网页使用
FlagEval(天秤)是智源研究院推出的大模型评测体系及开放平台,官方称旨在建立科学、公正、开放的评测基准、方法、工具集,协助研究人员全方位评估基础模型及训练算法的性能,并通过引入 AI 辅助主观评测提升评测效率与客观性。平台提供排行榜与大模型角斗场两个主要入口。
核心能力
- 语言大模型评测:官方称覆盖数学能力、代码能力、知识运用、推理能力、任务解决、指令遵循以及安全与价值观等维度。
- 多模态大模型评测:官方称考察图文分类、图文匹配与图文生成等任务,包含视觉语言模型、文生图与文生视频评测集。
- 计算机视觉评测:官方称支持主干基础模型适配评测,覆盖图像分类、图像检索、语义分割、深度估计与小样本分类等任务。
- 语音语言大模型评测:官方称覆盖语音感知、音频感知、语音生成与口语理解等十类任务,使用多个数据集与丰富指标。
- 大模型角斗场:官方称提供对抗式对比评测入口,用于收集主观偏好类评价。官方称评测体系由智源研究院推出。
- 评测工具与流程:官方称提供覆盖公开数据集与自建数据集的评测流程,结合自动评测与人工评测两种方式。官方称平台通过引入 AI 辅助主观评测提升评测效率与客观性。
适合谁
- 模型研发团队:用统一基准定位模型在不同能力维度上的位置。
- 学术研究者:引用带方法说明与数据集来源的评测结果做对比实验。官方称目标是建立科学、公正、开放的评测基准、方法、工具集。
- 企业选型人员:按业务相关维度查看模型表现,辅助采购与接入决策。
- 评测方法研究者:参考平台的评测流程设计自己的评价体系。
- 关注模型安全的人:查阅安全与价值观维度的评测结论。官方称平台提供排行榜与大模型角斗场两个主要入口。
使用建议
- 关注评测数据的发布时间与模型版本,模型迭代很快,旧结论容易失效。
- 按业务场景挑选相关维度,综合分高不等于在你的任务上表现最好。
- 自建评测集时参考其任务划分方式,覆盖基础能力与下游任务两类视角。
- 主观评测存在偏好差异,人工评测结论需要关注样本量与标注口径。
- 引用评测结果时保留平台名称与评测时间,确保结论可追溯。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
FlagEval天秤 每月约有 1.0 万次访问,在「其他」150 个同类工具中排第 130 位。近一个月流量下降 36.3%。
月访问量
1.0万
较上月 -36.3%较3月前 +44.7%
跳出率
35.6%
只看一页就离开,越低越好
平均时长
01:20
每次访问的平均停留
次均页数
2.78页
每次访问浏览的页面数
近 12 个月当月 1.0 万
8,624
1.2 万
1.2 万
2.7 万
7,250
1.1 万
8,114
7,027
7,208
6,603
1.6 万
1.0 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 中国45.3%
- 越南17.3%
- 德国13.1%
- 中国香港8.4%
- 美国7.4%
流量来源
访客从哪里进来- 直接访问43.3%
- 搜索引擎32.3%
- 外链引荐12.2%
- 社交媒体5.7%
- 邮件1.9%
- 展示广告1.7%
- 其他2.9%
「其他」内排名低于中位数 92%
第130名
共 150 个同类工具
本工具
1.0 万
中位数
12.4 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考