
AGI-Eval
研究分析AGI-Eval是大模型评测社区,提供评测榜单、评测集、人机竞赛与Data Studio,以透明权威的得分帮助选型者了解各模型优劣。
大模型评测能力榜单评测集共建
月访问量2.2 万↓36.9%
全球排名#833,492
月访问量为第三方平台估算,仅供参考界面预览
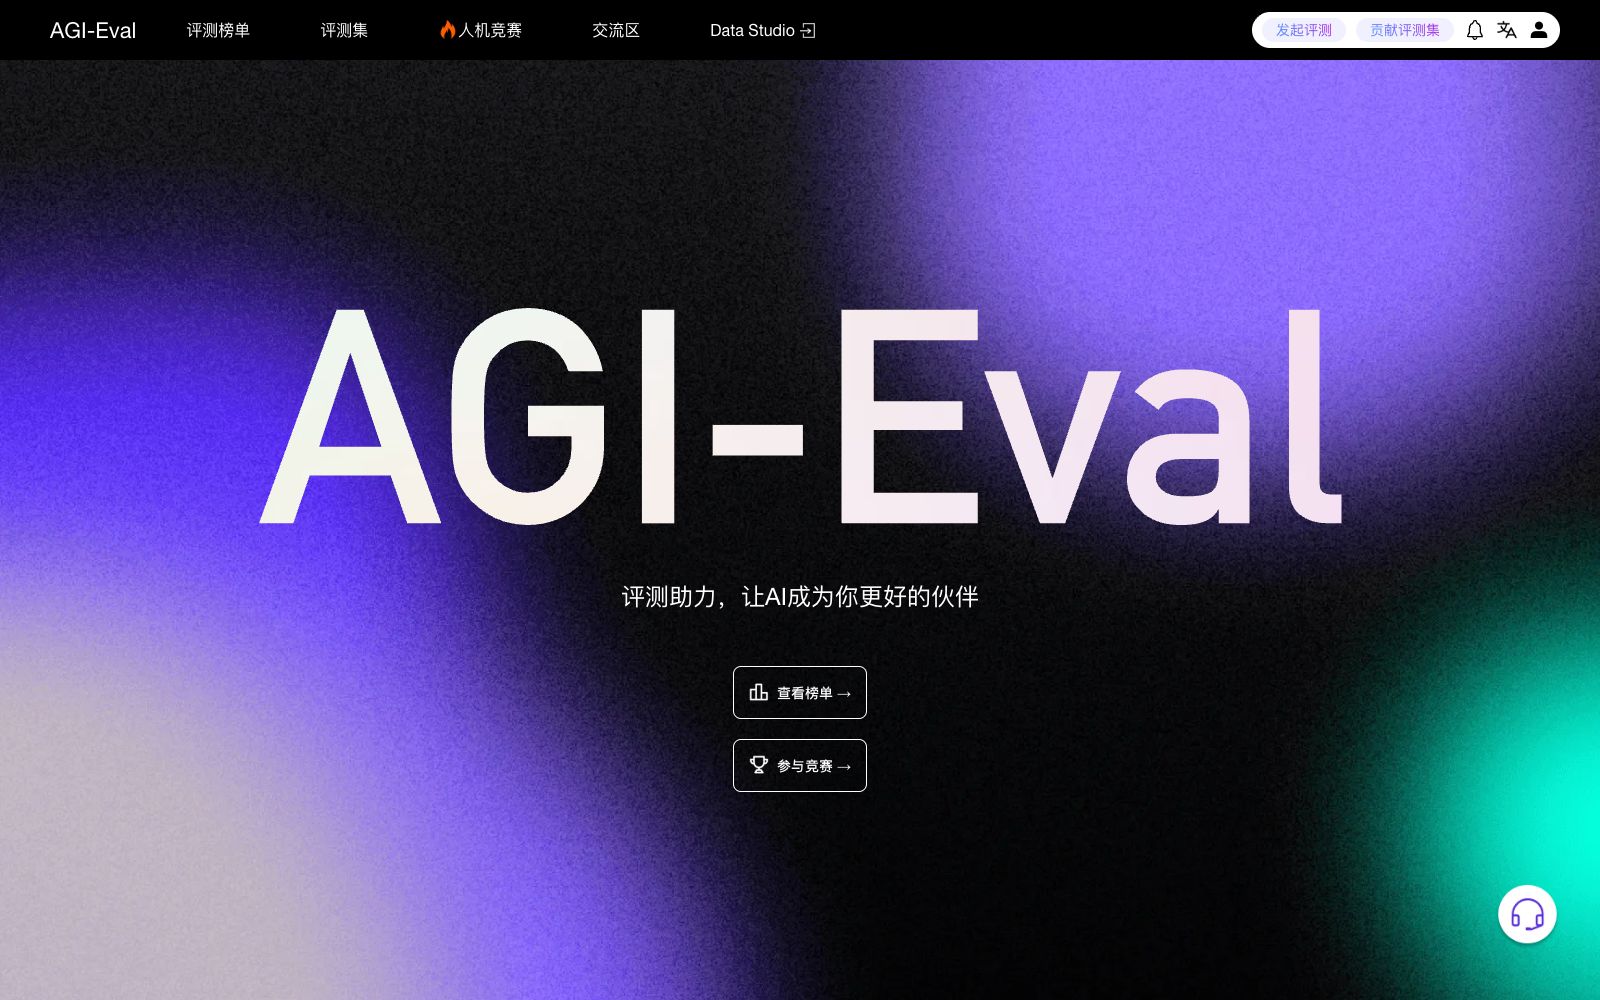
Deep Dive
更新于 2026-11-04详细介绍
快速了解
核心摘要- 是什么
- 面向大模型的能力评测社区,提供评测榜单、评测集、人机竞赛与数据工作室
- 核心能力
- 评测榜单、评测集共建、人机竞赛、Data Studio
- 使用方式
- 网页端查看榜单与参与评测,可共建评测集
导语:AGI-Eval是一个面向大模型的能力评测社区,提供评测榜单、评测集、人机竞赛与Data Studio等模块。它通过通用评测方案为大语言模型与多模态模型给出透明、权威的能力得分排名。社区还鼓励用户共建评测集,并联合高校与企业推动下一代评测标准的形成,帮助使用者做出更明智的模型选择。
核心能力
- 模型榜单基于通用评测方案,对大语言模型与多模态模型给出综合与各能力项得分。数据透明且定期更新。
- 评测集分为平台官方与用户自建两类,官方集覆盖多领域,用户也可贡献专业数据。共建让覆盖面更广。
- 人机竞赛让用户与大模型协作参与评测,探索下一代人机协同的评测方案。参与感与前沿性兼具。
- Data Studio支持个人贡献专业领域数据,以单条、扩写、Arena等多种方式收集。收集方式灵活多样。
- 数据审核采用机审加人审的多重机制,保障评测数据的质量与可信度。多重审核守住数据底线。
适合谁
- 模型选型者希望借助透明榜单,深入了解各模型优缺点后做出明智选择。选型不再靠感觉。
- 高校与研究机构可参与评测集共建,把专业领域知识转化为评测标准。学术积累有了出口。
- 算法工程师关注模型排名与能力项得分,用于横向比较与方案选型参考。能力项维度更精细。
- 数据贡献者能围绕五百多个任务标签,持续补充多领域多维度的评测数据。标签体系支撑细分。
- 关注AI发展的个人可参与人机评测,在体验前沿科技的同时获得回馈。体验与收益兼得。
使用建议
- 选型前先查看完整榜单,按综合分与具体能力项双重维度评估候选模型。单看总分容易误判。
- 自建评测集时遵循平台规范,借助机审加人审机制保证数据可被采信。规范是数据被采用的前提。
- 参与人机竞赛既能体验模型能力,也能为社区评测标准建设提供反馈。反馈帮助标准更完善。
- 关注合作机构与贡献者动态,及时获取新的评测集与研究方向的更新。动态更新反映前沿。
- 解读榜单得分时结合任务场景,分数高不等于在所有业务上都更合适。场景匹配才是关键。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
AGI-Eval 每月约有 2.2 万次访问,在「研究分析」50 个同类工具中排第 29 位。全球排名第 833,492 位(新兴站点),近一个月流量下降 36.9%。
月访问量
2.2万
较上月 -36.9%较3月前 +43.8%
跳出率
5.9%
只看一页就离开,越低越好
平均时长
48:30
每次访问的平均停留
次均页数
28.09页
每次访问浏览的页面数
近 12 个月当月 2.2 万
2.7 万
2.4 万
3.6 万
3.9 万
1.7 万
2.6 万
2.1 万
2.1 万
1.5 万
3.0 万
3.4 万
2.2 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 中国81.2%
- 美国18.8%
流量来源
访客从哪里进来- 直接访问95.9%
- 外链引荐2.4%
- 搜索引擎0.9%
- 社交媒体0.7%
- 其他<0.1%
「研究分析」内排名低于中位数 27%
第29名
共 50 个同类工具
本工具
2.2 万
中位数
2.9 万
2026-09 数据 · 更新于 2026-11-01尚未更新到下月第三方平台估算,仅供参考