SEAL LLM Leaderboard
研究与数据分析Scale AI 旗下 Labs 出品的专家驱动评测榜单,覆盖智能体编程、前沿推理与安全对齐等 20 多个基准、100 多个模型,可按能力维度分档浏览并持续更新。
详细介绍
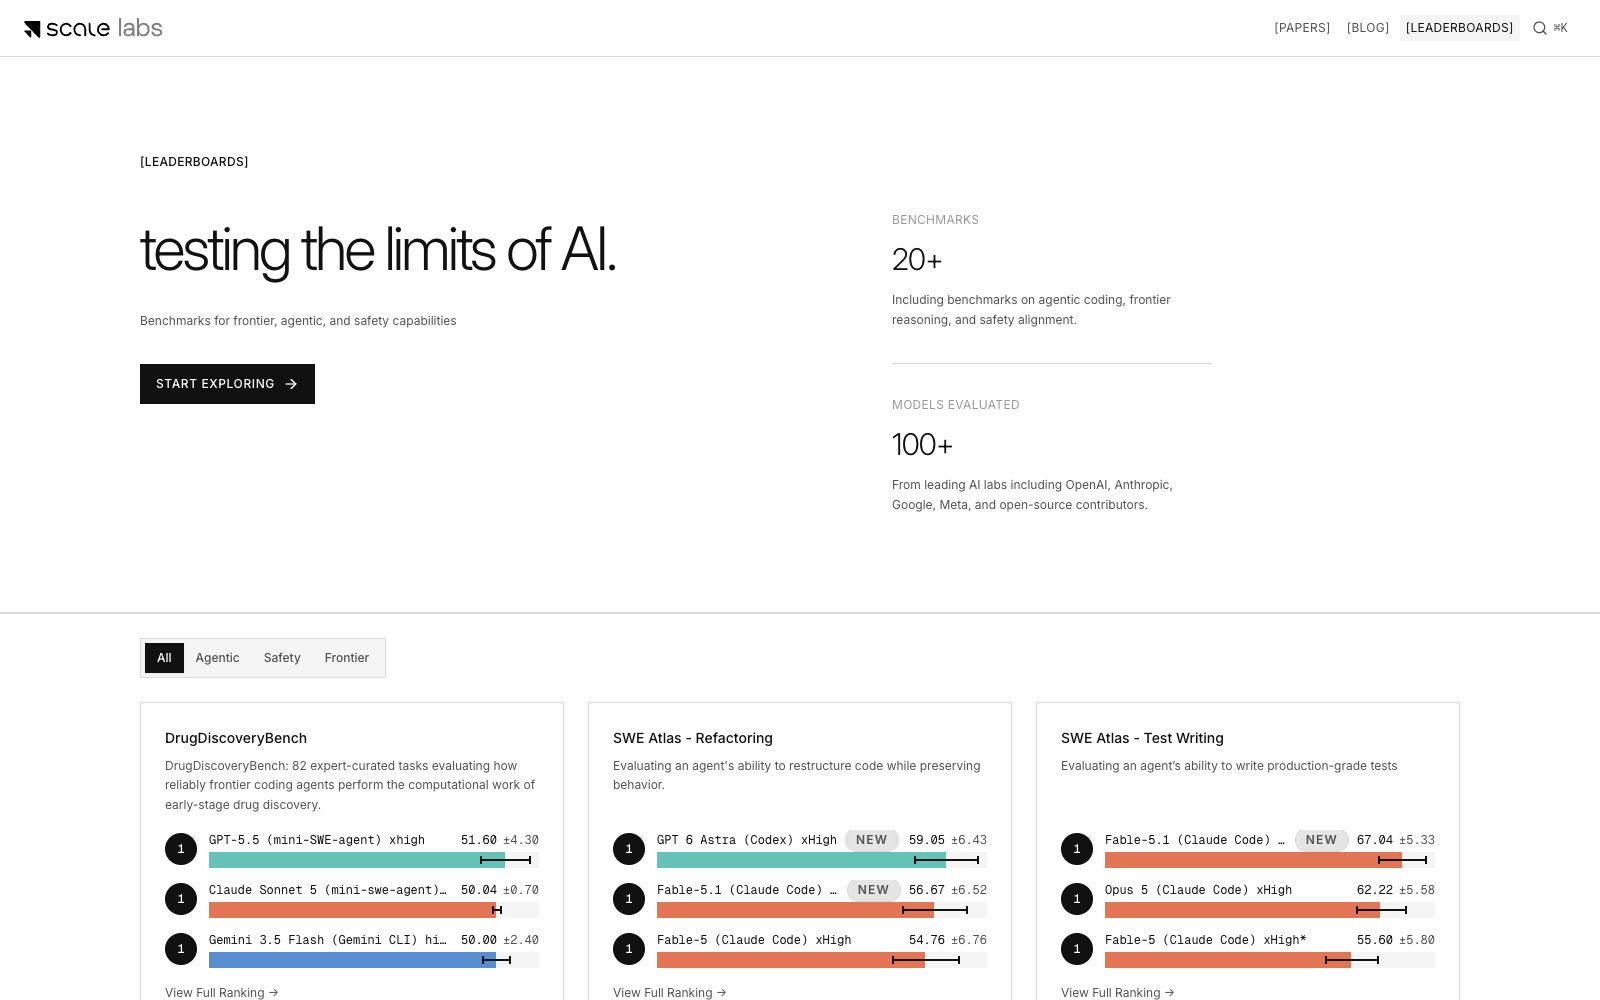
SEAL LLM Leaderboard 是 Scale AI 旗下 Scale Labs 推出的 AI 模型评测榜单集合,定位是「测试 AI 的极限」。与纯自动打分的基准不同,它强调专家驱动:由领域专家设计并标注评测任务,降低自动基准容易出现的「刷分」问题。目前收录 20 多个基准、评测 100 多个模型,覆盖智能体编程、前沿推理与安全对齐等方向,模型来源包括 OpenAI、Anthropic、Google、Meta 等主流实验室与开源贡献者。
核心能力
- 专家驱动出题:基准任务由领域专家策划与标注,例如 DrugDiscoveryBench 包含 82 个专家策划任务,评估前沿编码智能体执行早期药物发现计算工作的可靠性。
- 智能体编程评测:覆盖 SWE-Bench Pro(分公开与私有数据集)、SWE Atlas(重构、写测试、代码库问答)等面向真实代码库的基准,检验编码智能体的落地能力。
- 前沿推理基准:收录 Humanity's Last Exam 等高难度通用推理测试,探索模型能力边界。
- 专业领域基准:设有金融、法律的专业推理基准,以及药物发现等垂直方向任务,贴近行业真实需求。
- 智能体与安全方向:包含 HiL-Bench(人在回路基准)、MCP Atlas、SciPredict 等智能体相关评测,以及安全对齐(Safety)方向的能力验证。
- 音频多模态:AudioMultiChallenge 覆盖音频多轮对话与音频输出能力。
适合谁
需要为自己的场景挑选模型的技术团队与架构师;需要引用权威基准数据支撑选型报告的工程师与分析师;以及关注前沿模型真实能力边界的研究者。榜单按 All / Agentic / Safety / Frontier 分档浏览,可快速定位到关心的能力维度。
使用建议
榜单基准多、数据量大,建议先按自己关心的能力维度(如智能体编程或专业推理)筛选,再看具体名次;同款基准常有公开数据集与私有数据集两个版本,两者分数差异本身也是重要信息,能反映模型的泛化与鲁棒性。涉及具体选型时,把榜单当缩小候选范围的工具,再结合自己的真实任务做一轮小规模验证。
注意事项
榜单分数与具体模型版本、评测环境绑定,引用时需注明基准版本与评测时间;专家基准覆盖的任务类型有限,不能代表全部使用场景,尤其长尾与垂直场景需要单独验证;部分基准有公开与私有两套数据,公开榜上的分数可能高于私有数据表现,参考时留意数据来源;榜单由 Scale Labs 维护,评测方法与入选模型以官网为准。
相似工具
OpenRouter LLM Rankings
按真实调用量排名的 LLM 使用榜单,基于开发者通过 OpenRouter API 处理的 token 数统计,提供任务、成本与市场份额等多维排名,反映生产环境的真实选择。
同标签 · 排行榜 / LLM
Artificial Analysis
独立评测 AI 模型与 API 服务商的基准站,围绕智能指数、输出速度与单任务成本横向对比,覆盖编码、语音、图像、视频等多门类榜单与搜索服务商对比。
同标签 · 评测
LLM Stats
把 300 多个 AI 模型的智能水平、速度与价格折算成单一综合分的独立榜单,数据持续从公开基准与真实 API 指标更新,支持多任务维度排行。
同标签 · 排行榜
Arena
众包模式的 AI 模型竞技场,两个模型匿名对战由用户投票分胜负,并据此生成 LLM、图像与代码模型的公开排行榜,内置落地页、仪表盘、小游戏等任务模板可直接实测。
同标签 · 排行榜

FlagEval天秤
智源研究院的大模型评测体系与开放平台,官方称覆盖语言、多模态、计算机视觉与语音四类评测场景,提供排行榜、大模型角斗场与自动加人工结合的评测方法与工具集。
内容相近

Kaggle
Google 旗下数据科学与 AI 社区平台,集成公开数据集、云端 Notebook、算法竞赛、预训练模型与免费课程,提供免费 GPU/TPU,覆盖从入门到前沿基准的全流程。
同分类