OpenRouter LLM Rankings
研究与数据分析按真实调用量排名的 LLM 使用榜单,基于开发者通过 OpenRouter API 处理的 token 数统计,提供任务、成本与市场份额等多维排名,反映生产环境的真实选择。
详细介绍
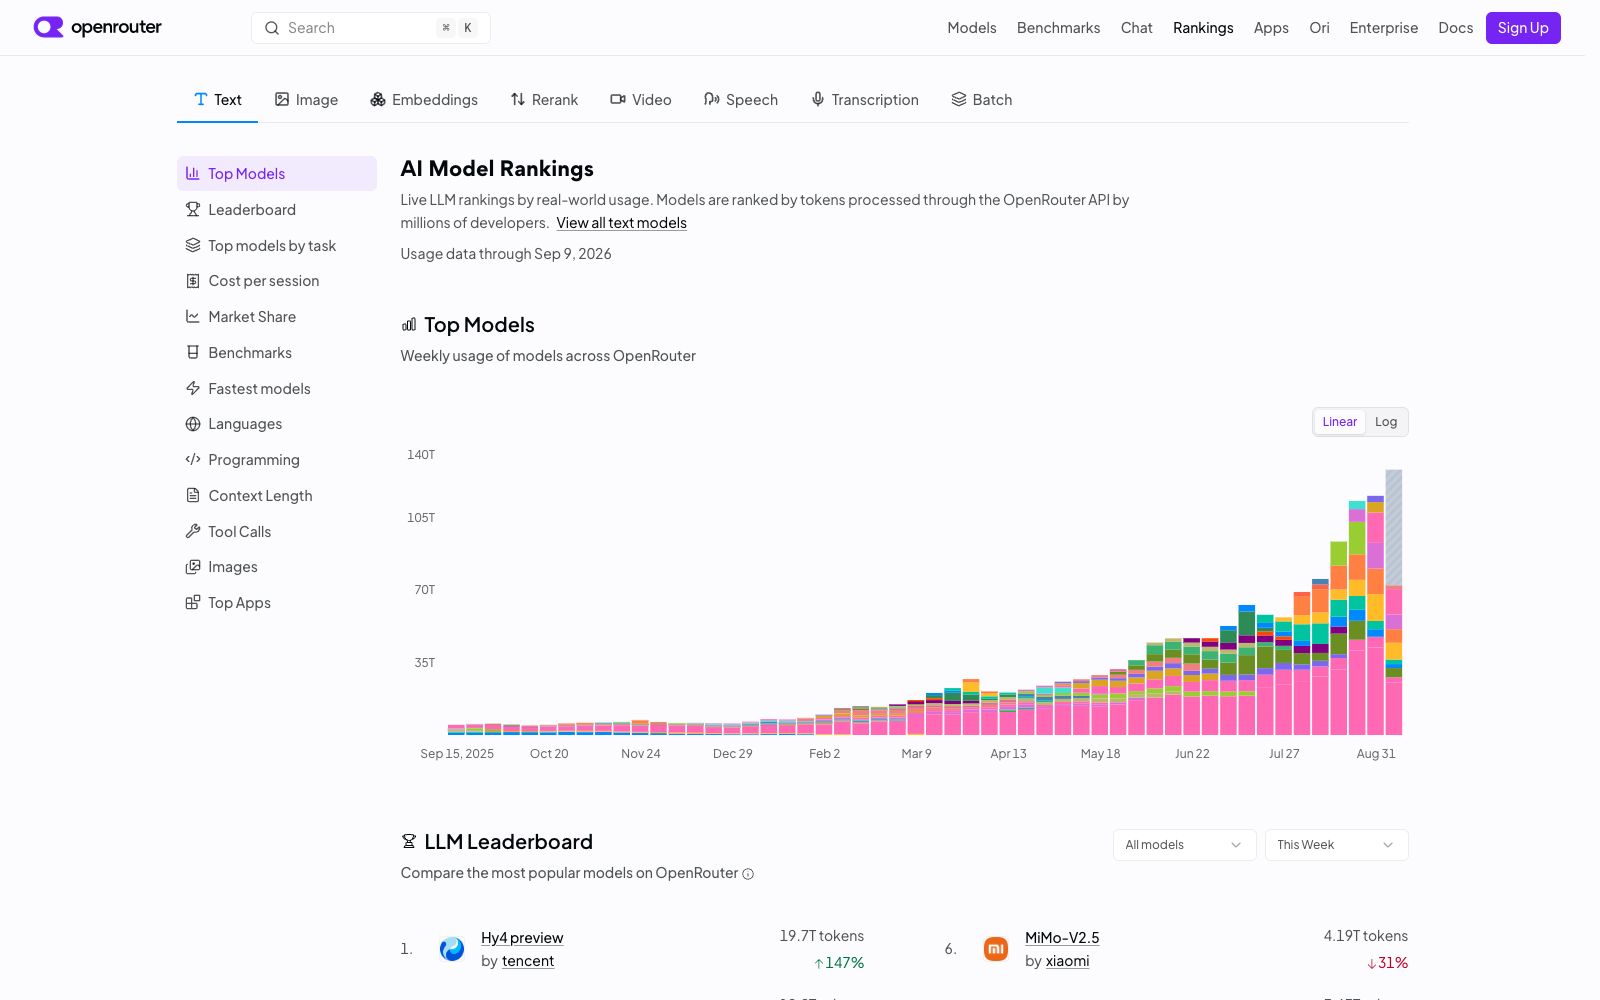
选模型时,跑分榜单常和真实体验脱节:分数高不代表同行真的在用,营销宣传也时常夸大实际能力。OpenRouter 的 LLM Rankings 换了一个更朴素的标尺——用「实际用了多少」而不是「跑分多少」来排名。模型名次由开发者通过 OpenRouter API 处理的 token 量决定,官方称之为「按真实用量计算的实时 LLM 排名」,数据覆盖数百万开发者的实际调用,反映的是生产环境里的真实选择。
核心能力
- 真实用量排名:排名基于数百万开发者通过 OpenRouter API 处理的 token 量统计,不受厂商宣传影响;页面提供模型周用量走势图,可直观观察各模型在不同时间段的用量上升与回落。
- 多模型类型覆盖:除文本模型外,还覆盖图像、嵌入、重排、视频、语音与转录等模型类型,并设批量处理维度,满足不同任务形态的选型需求。
- 按任务分榜:在总榜之外,提供编程、语言、上下文长度、工具调用、图像等任务维度的分项排名,便于按具体场景查找合适的模型,而不是只看总榜。
- 成本与市场视角:提供每次会话成本等指标,可结合预算评估性价比;市场份额视图呈现不同模型与厂商在调用量上的占比变化,帮助判断生态格局。
- 榜单口径透明:官方公开说明排名如何统计、统计对象、统计周期与数据新鲜度,并明确「这些排名不证明什么」,帮助用户正确解读榜单边界。
适合谁
想了解「同行实际在用哪些模型」的开发者与创业者,做技术选型的架构师,需要真实用量数据支撑行业分析的研究者,以及关注模型成本变化、想找到高性价比方案的工程师。
注意事项
榜单数据来自 OpenRouter 平台,反映的是该平台用户的用量,并非全网全貌——自建部署、直连厂商 API 的流量不会计入,解读市场份额时应留意这一口径;token 量与模型定价、免费额度密切相关,便宜或免费开放的模型容易排名靠前,最新最强的模型可能因价格高而用量偏低。此外,用量数据按周期更新,查看时应留意数据截止时间;榜单衡量的是「用了多少」,不等于「能力多强」,两者要区分看待。
使用建议
用量榜反映的是普及度而非能力上限,建议把它与能力基准榜结合看:一个说明大家选了什么,一个说明最好能做到什么。选型时可按自己的任务类型先看对应分榜,再结合会话成本、上下文长度与输出速度等指标做最终决定;关注成本变化时,每周用量走势能帮你判断哪些模型正在成为新的默认选项。
所属专题
相似工具
SEAL LLM Leaderboard
Scale AI 旗下 Labs 出品的专家驱动评测榜单,覆盖智能体编程、前沿推理与安全对齐等 20 多个基准、100 多个模型,可按能力维度分档浏览并持续更新。
同标签 · 排行榜 / LLM
LLM Stats
把 300 多个 AI 模型的智能水平、速度与价格折算成单一综合分的独立榜单,数据持续从公开基准与真实 API 指标更新,支持多任务维度排行。
同标签 · 排行榜
Arena
众包模式的 AI 模型竞技场,两个模型匿名对战由用户投票分胜负,并据此生成 LLM、图像与代码模型的公开排行榜,内置落地页、仪表盘、小游戏等任务模板可直接实测。
同标签 · 排行榜

Dify
Dify 是面向生产级 Agentic 工作流的开源 LLM 应用开发平台,在统一画布上搭建 Agent、知识管道(RAG)与工作流,支持云端、VPC 或自托管部署。
同标签 · LLM
LangChain
LangChain 是构建大模型应用的主流开源框架,配 LangSmith Engine 覆盖 Agent 的构建、测试、部署与监控全周期,掌控模型、上下文与执行框架,被 700
同标签 · LLM
LMQL
面向大语言模型交互的查询编程语言,用类型、模板与约束描述输出,配优化运行时,让提示词更稳健、更可复用,跨本地与云端后端。
同标签 · LLM