
SuperBench
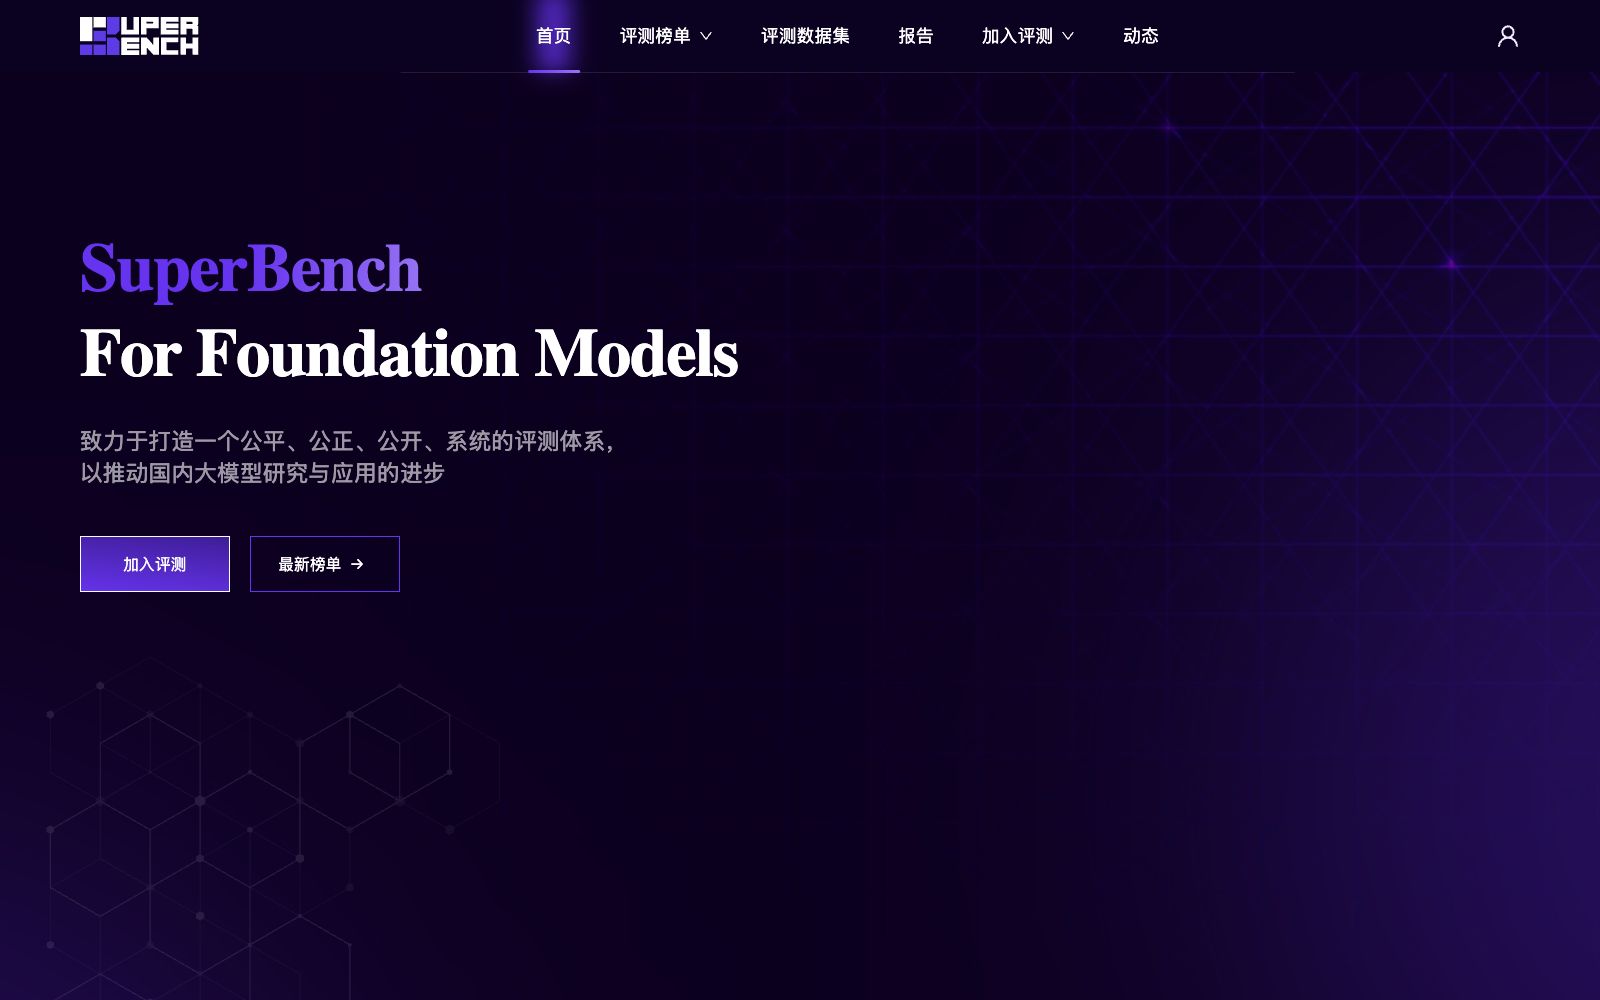
AI搜索清华大学基础模型研究中心联合中关村实验室发布的大模型综合能力评测榜单,以双月报告推动公平、公开、系统的大模型评测与技术进步。
大模型评测第三方榜单学术基准
月访问量5,685↓8.4%
月访问量为第三方平台估算,仅供参考界面预览
Deep Dive
更新于 2026-11-04详细介绍
快速了解
核心摘要- 是什么
- 清华大学基础模型研究中心联合中关村实验室发布的大模型综合能力评测榜单,以双月报告持续更新
- 核心能力
- 大模型综合评测、双月报告、动态题目更新、公开验证集、可追溯评测过程
- 使用方式
- 网页端查看最新榜单与评测数据集,结合自身任务对照原生基准解读分数
SuperBench 是由清华大学基础模型研究中心联合中关村实验室发布的大模型综合能力评测榜单。它致力于打造公平、公正、公开、系统的评测体系,以双月级报告推动国内大模型研究与应用进步,是独立的第三方非盈利性机构,过程可追溯。
核心能力
- 由清华与中关村实验室联合发布,是独立的第三方非盈利性评测机构,过程可追溯,结论更可信。
- 率先提出五项大模型原生评测基准,并构建检测平台与自研裁判模型 CritiqueLLM,评测更科学。
- 开放性结合开源与闭源数据集,后续推出公开验证集与封闭测试集防止刷题,兼顾优化与防作弊。
- 动态性体现在定期刷新题目与类型,避免静态考题导致的过拟合与作弊,榜单更经得起时间。
- 科学性基于公平公开原则设计整套评测体系,确保结果客观可靠,方法可复现。
- 评测结果以双月级报告对外发布,并持续跟踪新的主流开源与闭源模型,保持时效性,也方便横向回溯历史表现。
适合谁
- 大模型研发团队,可用榜单横向对比主流开源与闭源模型能力,定位自家模型位置。
- 选型中的企业,可参考评测结果挑选适合自身场景的模型,减少试错成本。
- 高校与研究机构,能基于公开基准开展模型研究与教学,把评测当标尺。
- 关注行业动态的从业者,可跟踪双月级报告了解技术走向,把握演进节奏。
- 需要第三方背书的采购方,可借权威榜单降低选型风险,决策更有依据,也便于向上汇报。
使用建议
- 先看最新榜单与评测数据集,明确各模型在不同基准上的表现,再下判断。
- 结合自身任务对照原生评测基准,避免只看总分下结论,场景匹配才重要。
- 关注动态发布的题目更新,理解榜单防过拟合的设计意图,正确解读分数。
- 需要深入评估时可联系团队加入评测,获取更贴合的测试结果,而非只看公开榜。
- 把双月报告当作周期参考,持续跟踪模型能力的演进趋势,把握升级窗口。
- 借助公开验证集做模型优化,但避免在封闭测试集上直接刷题,守住评测公正。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
SuperBench 近一个月流量下降 8.4%,月访问量约 5,685,在「AI搜索」49 个同类工具中排第 45 位。
月访问量
5,685
较上月 -8.4%较3月前 -13.1%
跳出率
48.6%
只看一页就离开,越低越好
平均时长
01:35
每次访问的平均停留
次均页数
1.88页
每次访问浏览的页面数
近 12 个月当月 5,685
6,255
6,486
5,412
6,494
5,652
5,720
5,873
6,173
6,540
6,195
6,207
5,685
10月11月12月1月2月3月4月5月6月7月8月9月
「AI搜索」内排名低于中位数 97%
第45名
共 49 个同类工具
本工具
5,685
中位数
18.5 万
2026-09 数据 · 更新于 2026-11-01尚未更新到下月第三方平台估算,仅供参考