SuperCLUE
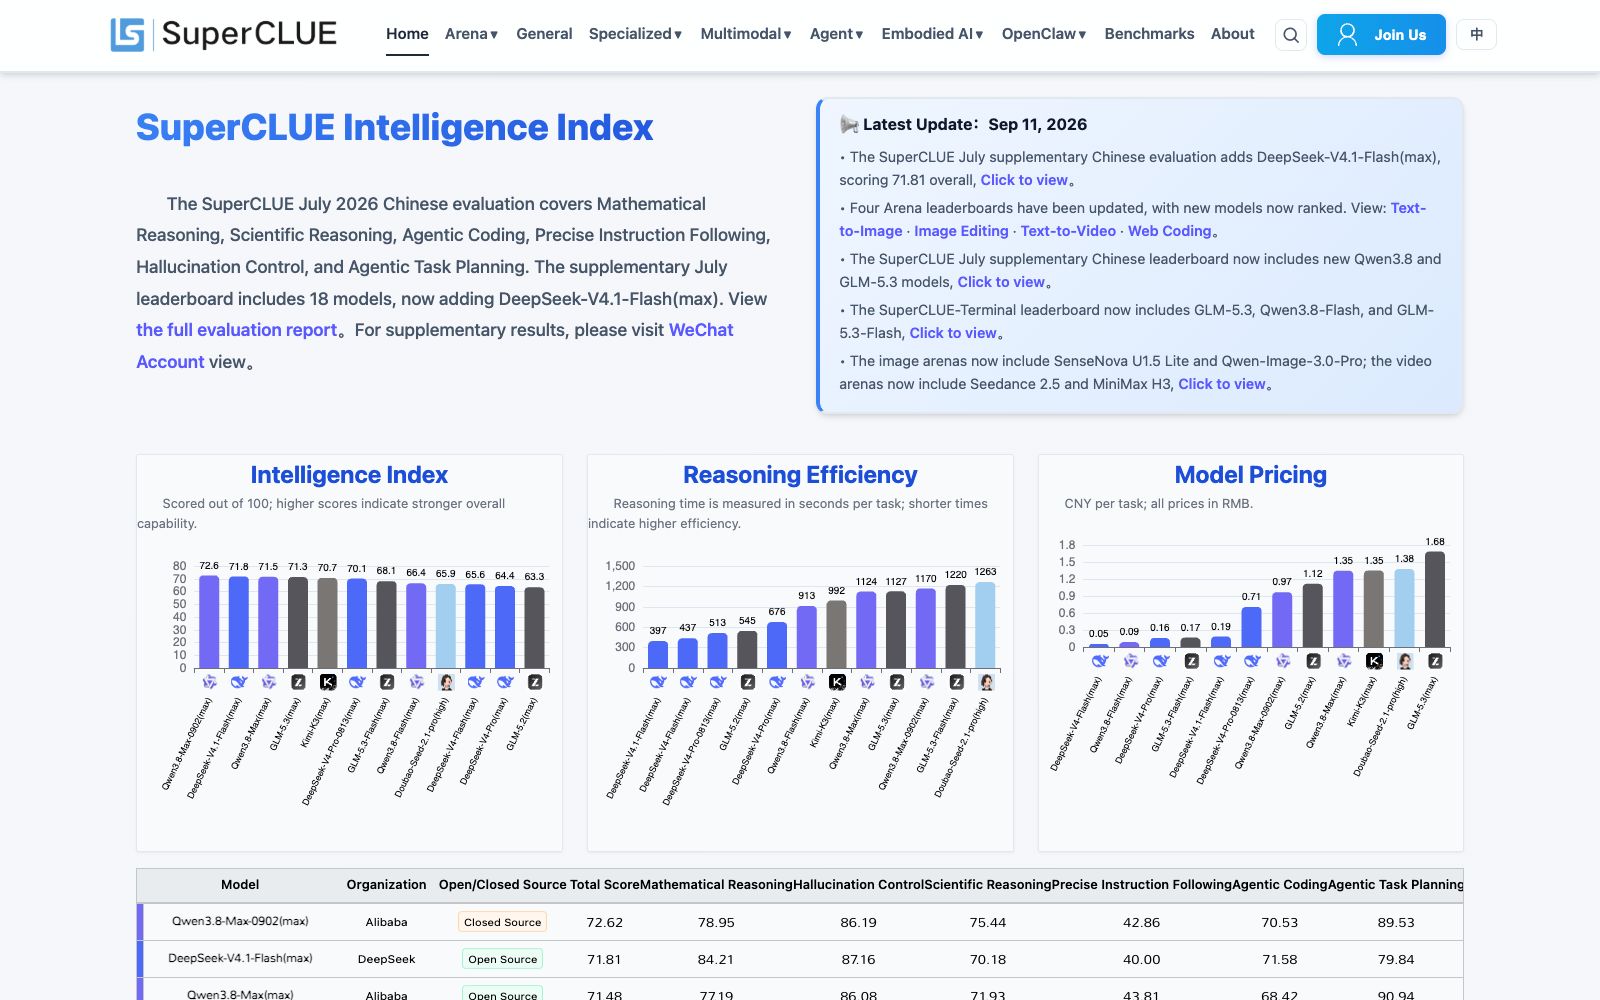
其他中文大模型测评基准,官方称以通用能力总榜与数学推理、幻觉控制、科学推理、精确指令遵循、智能体编程等分项榜单呈现模型表现,并同步给出模型价格与任务规划消耗数据。
大模型评测中文榜单模型选型
月访问量15.0 万↓21.7%
全球排名#226,134
月访问量为第三方平台估算,仅供参考界面预览
Deep Dive
更新于 2026-09-13详细介绍
SuperCLUE 是面向中文大模型的测评基准,官方提供通用能力总榜以及数学推理、幻觉控制、科学推理、精确指令遵循、智能体编程、智能体任务规划等分项榜单,同时给出模型价格与 Agentic 任务规划的 Token 消耗数据。官方说明为减少分数波动,差距在一分以内的模型按并列处理,国际模型与部分国内模型不参与排名、仅作参考。
核心能力
- 通用能力总榜:官方按总分对模型排序,并展示开放或闭源、接入方式、是否推理模型与评测日期等字段。
- 分项能力榜:官方分别给出数学推理、幻觉控制、科学推理、精确指令遵循、智能体编程与智能体任务规划等维度得分。
- 模型价格信息:官方提供 Model Pricing 板块,便于把能力得分与调用成本放在一起比较。
- Token 消耗数据:官方以 Agentic 任务规划每任务平均 Token 数呈现模型完成同类任务的消耗差异。
- 区域与接入方式筛选:官方支持按开放或闭源、接入方式筛选,帮助用户按可获取性查看结果。
- 榜单图表下载:官方称榜单结果支持下载图片,方便在汇报与材料中引用。
适合谁
- 企业选型负责人:把能力得分与价格放在一起看,避免只看单一榜单排名做决策。
- 算法工程师:用分项榜单定位模型在幻觉控制或指令遵循上的短板,决定是否需要微调。
- 产品经理:按业务场景挑选对应维度表现更好的模型,例如重推理还是重指令遵循。
- 研究或媒体从业者:引用可追溯的评测口径与评测日期,避免使用无来源的排名。
- 关注推理成本的团队:参考 Token 消耗数据估算智能体类应用的调用成本。
使用建议
- 先确认评测日期与模型版本,榜单排名会随模型更新频繁变动,用旧数据做结论容易误导。
- 把榜单当筛选工具而不是结论,选型前一定要用自有业务数据做小规模实测。
- 注意并列处理的规则,分差很小的模型不应被当作能力上有明显差距。
- 分项榜单要按业务权重看,客服场景更关心幻觉控制,代码场景更关心编程与指令遵循。
- 引用数据时保留评测方名称与时间,避免二次传播中丢失口径导致误读。此外,这类偏基础设施与社区型的工具,价值往往在使用一段时间后才显现:早期多花点时间熟悉它的数据结构和接口约定,后续接入自有工作流的成本会明显下降。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
SuperCLUE 每月约有 15.0 万次访问,在「其他」150 个同类工具中排第 72 位。全球排名第 226,134 位(新兴站点),近一个月流量下降 21.7%。
月访问量
15.0万
较上月 -21.7%较3月前 -2.1%
跳出率
29.5%
只看一页就离开,越低越好
平均时长
00:30
每次访问的平均停留
次均页数
2.67页
每次访问浏览的页面数
近 12 个月当月 15.0 万
9.6 万
11.0 万
11.3 万
13.9 万
16.3 万
20.3 万
24.7 万
17.0 万
15.3 万
18.3 万
19.1 万
15.0 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 中国78.9%
- 美国5.5%
- 新加坡5.4%
- 中国香港5.3%
- 中国台湾1.9%
流量来源
访客从哪里进来- 直接访问41.3%
- 搜索引擎37.4%
- 外链引荐18.5%
- 社交媒体2.5%
- 其他0.4%
「其他」内排名高于中位数 20%
第72名
共 150 个同类工具
本工具
15.0 万
中位数
12.4 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考