Scrapeless
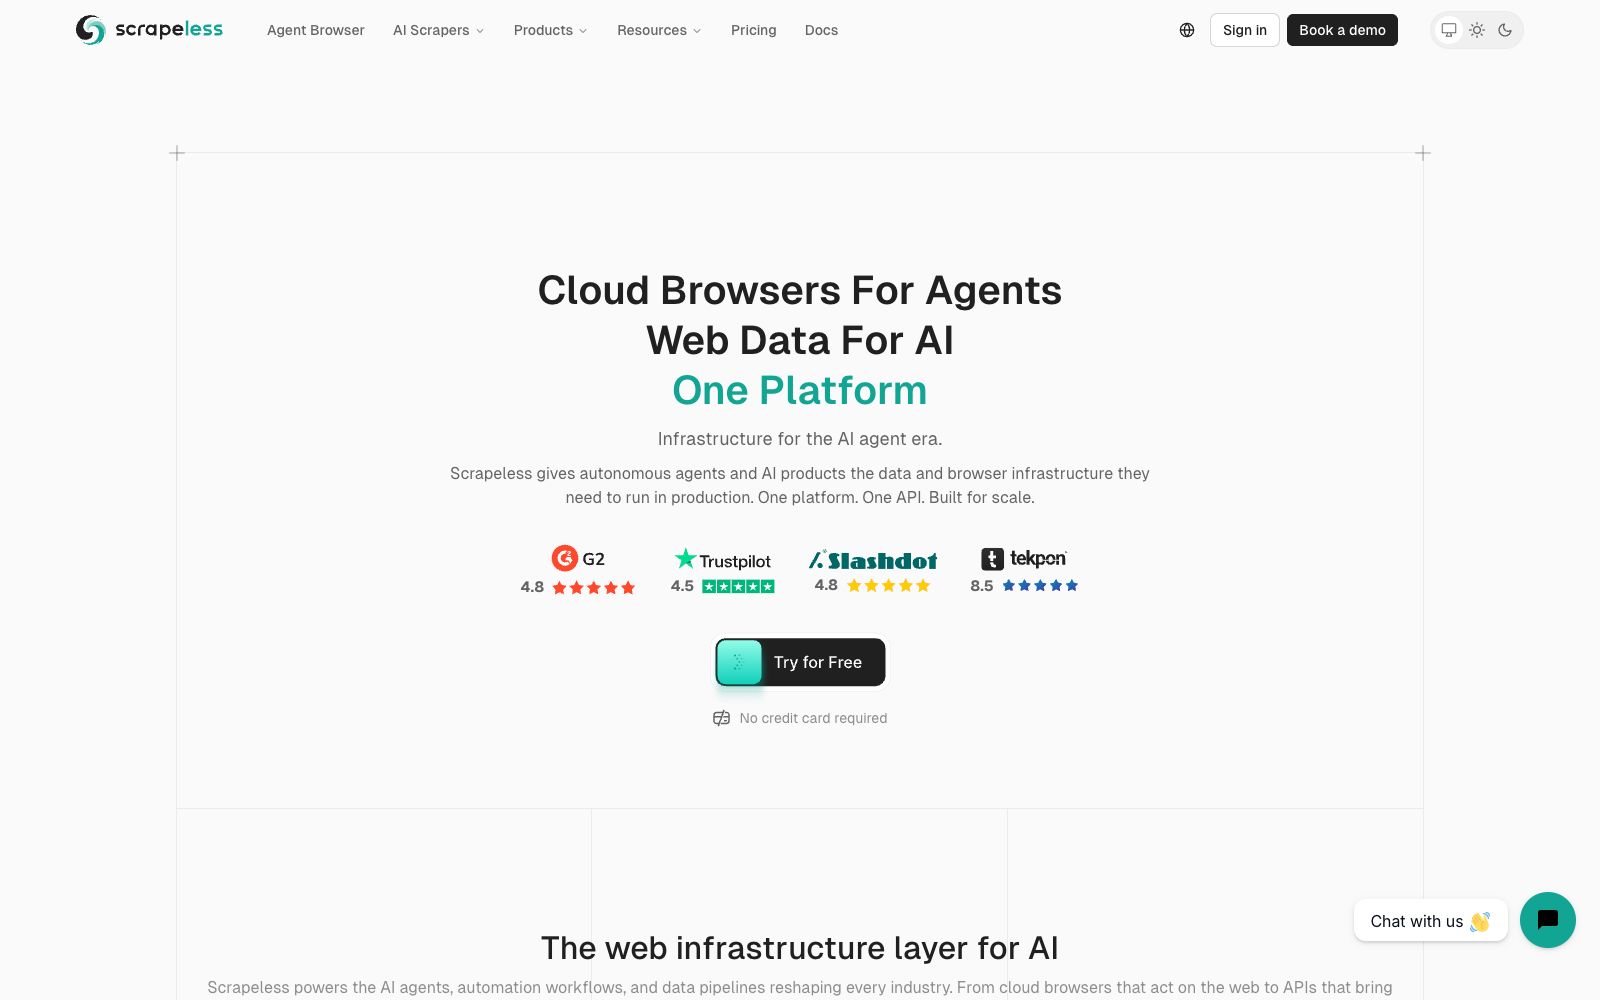
AI数据处理面向智能体与数据团队的网页数据基础设施,把云端浏览器、网页解锁、整站爬取和代理网络收进一套接口,适合训练语料采集、竞品价格监控与搜索结果结构化。
网页抓取代理IP数据采集
月访问量5.7 万↑36.8%
全球排名#765,540
月访问量为第三方平台估算,仅供参考界面预览
Deep Dive
更新于 2026-10-22详细介绍
Scrapeless 是面向 AI 智能体与数据团队的网页数据基础设施,把云端浏览器、网页解锁、整站爬取和代理网络收进一套 API。它不卖现成数据集,而是提供让程序真正打开网页的底层能力:真实浏览器、验证码处理、登录态保持。对需要稳定批量取数的团队来说,省掉的是自建代理池和反爬对抗那部分长期维护成本。
核心能力
- 智能体浏览器:在云端跑真实浏览器而不是无头模拟,兼容 Puppeteer 与 Playwright,提供实时查看、会话回放、持久化配置、MFA 与浏览器扩展支持。官方称接入 7000 万以上住宅 IP、覆盖 195 个国家。
- 网页解锁:提交一个 URL 直接返回渲染后的内容,内置 JS 渲染、浏览器指纹识别、验证码自动处理与 IP 轮换。官方称只对成功的请求计费。
- 整站爬取:递归抓取整个站点,输出 JSON、Markdown、HTML 或截图。官方称标准配置提供 50 个并发会话,验证码处理免费,相比同类可省约 70% 成本。
- AI 引擎抓取:官方称可从 ChatGPT、Perplexity、Gemini、Copilot 等引擎批量取回提示词、回答与引用来源,以 Markdown 输出,用于观察品牌在 AI 搜索里的实际呈现。
- 搜索与代理:Google 搜索结果可转成结构化 JSON,支持国家与语言定向;代理覆盖住宅、ISP、数据中心与 IPv6,支持 HTTP、HTTPS 与 SOCKS5。
适合谁
- 做 RAG 与智能体的开发者:需要给模型喂实时网页内容,又不想自己维护抓取管道和封禁处理。
- 训练语料团队:要把成规模站点转成 Markdown 或 JSON,直接进训练与清洗流程。
- 电商与零售数据分析:跟踪多个地区站点的价格、促销与库存变化。
- SEO 与品牌监测:批量拿搜索结果页排名,或统计品牌在生成式搜索中的被引用情况。
- 合规与研究机构:采集公开披露文件、监管公告与公开记录,需要可回溯的抓取过程。
使用建议
- 注册后先拿测试额度跑单条 URL,确认目标站点的成功率,再决定并发规模;官网写明无需信用卡即可开始。
- 遇到登录、二次验证的站点,用持久化配置配合实时查看,必要时人工接管一次,后续会话可复用。
- 计费按成功请求结算,正式跑批前先用小样本估算单页成本,避免递归爬取把额度吃光。
- 抓取公开数据仍受目标站点条款与当地法规约束,商用前建议让法务过一遍数据来源清单。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Scrapeless 每月约有 5.7 万次访问,在「AI数据处理」54 个同类工具中排第 31 位。全球排名第 765,540 位(新兴站点),近一个月流量增长 36.8%。
月访问量
5.7万
较上月 +36.8%较3月前 +58.8%
跳出率
45.8%
只看一页就离开,越低越好
平均时长
00:11
每次访问的平均停留
次均页数
1.59页
每次访问浏览的页面数
近 12 个月当月 5.7 万
2.8 万
3.8 万
6.8 万
6.8 万
3.8 万
4.3 万
3.4 万
2.8 万
3.6 万
2.6 万
4.1 万
5.7 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 印度25.1%
- 西班牙8.4%
- 美国7.7%
- 巴西4.7%
- 越南4.0%
流量来源
访客从哪里进来- 搜索引擎71.8%
- 直接访问21.5%
- 外链引荐3.9%
- 社交媒体2.2%
- 邮件0.3%
- 其他0.3%
「AI数据处理」内排名低于中位数 27%
第31名
共 54 个同类工具
本工具
5.7 万
中位数
7.8 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考
相似工具
Chat4Data 是 Chrome 上的 AI 网页抓取插件,用自然语言对话提取结构化数据,支持翻页点击,输出 Excel、CSV 或 JSON,登录验证交由人工。
同标签 · 数据采集 / 网页抓取
1.3 万/月

SheetMagic 把 AI 聊天代理与 64 个自定义公式嵌入 Google Sheets,支持网页抓取、线索发现、数据富化与内容生成,文本与抓取类公式免费可用。
同标签 · 网页抓取
1,223/月
