返回首页


Firecrawl
编程与开发面向 AI 智能体的网页数据接口,把搜索、抓取、整站爬取与页面交互做成一次 API 调用,直接返回适合喂给模型的干净数据。官方称对外开放源代码,已有大量公司在用。
网页抓取数据接口智能体基建
月访问量186 万↑0.5%
全球排名#28,527
月访问量为第三方平台估算,仅供参考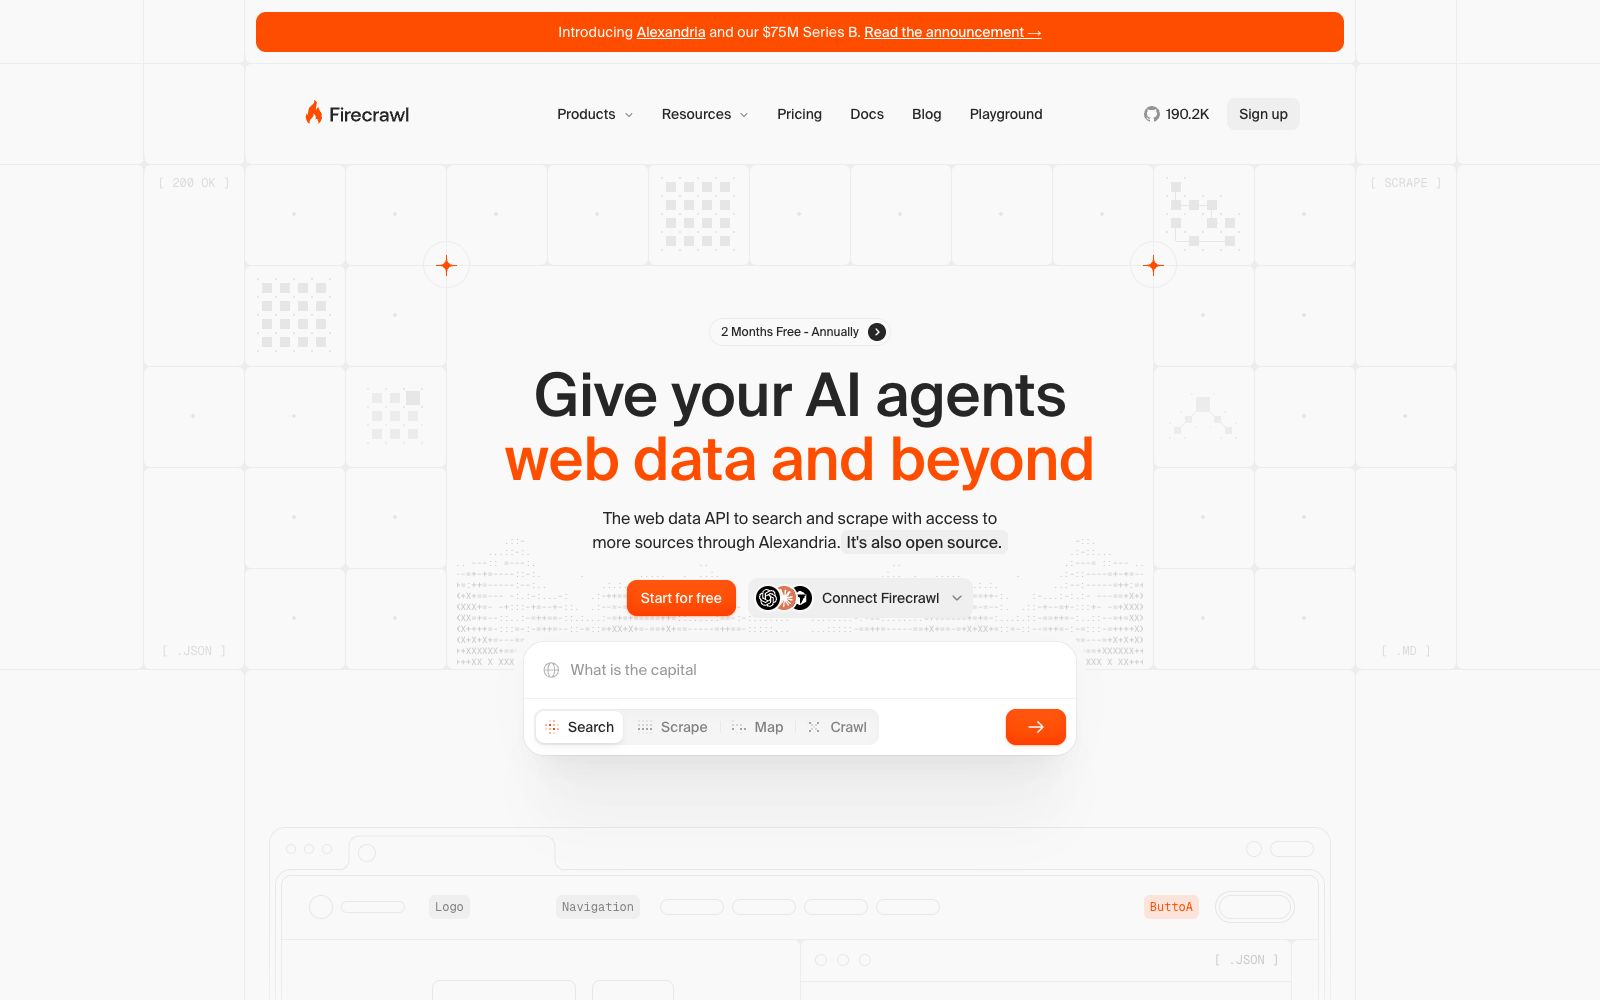
详细介绍
Firecrawl 是专为 AI 智能体设计的网页数据服务,官网定位是「Web Data API for AI Agents」,口号写着帮你把网页数据变成模型能直接用的东西。它把网页读取、搜索与交互封装成简单的接口,返回的结果已经是干净的结构化内容而不是原始 HTML,官网同时强调自己开源。
核心能力
- Scrape:抓取单个页面直接产出适合大模型消费的数据,可选 Markdown、JSON、截图等形态。
- Crawl:按站点范围批量爬取,省下自己写遍历与去重逻辑的时间。
- Map:快速摸清一个站点有哪些页面,作为后续抓取的路线图。
- Search:执行搜索并把结果里的完整正文一并取回,不用二次请求。
- Interact:官网标注为新增能力,先抓页面,再用自然语言或代码在页面上继续操作。
- 多种接入方式:同时提供 Python、Node.js、命令行等 SDK,官网称自己在速度、稳定性与 token 效率上做了优化。
适合谁
- 给智能体接实时联网能力,不想自己维护爬虫池与反爬对抗的开发者。
- 要给检索增强生成(RAG)系统建设文档语料,希望少写解析代码的团队。
- 需要定期批量采集竞品页面、公告与价格变动做监控的增长与研究人员。
- 想用 MCP 或 SDK 把网页读取能力塞进自己产品里的独立开发者。
使用建议
- 先用免费额度跑一两个真实站点,确认目标站的抓取质量与成本,再决定要不要上量。
- 需要登录或有反爬保护的站点,先确认条款是否允许、是否属于公开数据,别越过 robots 与站点规则。
- 爬到的数据涉及个人信息或受版权保护的内容时,别直接对外或做二次分发。
- 长页面建议先用 map 梳理范围,再按索引抓取,能明显降低无效请求与费用。
- 官网提供了年付折扣与托管套餐,计费与费率可能调整,正式接入前再核对一次定价页。
- 与智能体的衔接:官网在首页直接给出与主流 AI 工具和编辑器的连接示意,可嵌入现有的智能体工作流。
相似工具
Browserbase
给 AI 智能体提供云浏览器与沙盒运行环境的平台,一句提示就能发起任务并让它们在网页上像人一样操作,配套无头浏览、代理登录与调试回放能力。
同标签 · 智能体基建
Bardeen
一个面向获客与线索挖掘的 AI 工具,官方称可从任意网站提取数据、用 AI 搜索做线索调研,补全经过验证的联系方式并做资质筛选,结果同步到表格。
同标签 · 网页抓取
Tavily
面向 AI 智能体的实时搜索 API,提供搜索、抽取、爬取、地图与研究等接口,返回结构化分块内容;官方称内置拦截个人隐私信息与提示注入的安全校验层。
同分类
MindStudio
无需写代码即可设计、搭建并部署 AI 智能体的平台,内置两百多个模型与大量集成,官方称可自带 API 密钥,最近上线了从想法直接产出完整应用的产品智能体。
同分类