Gaga
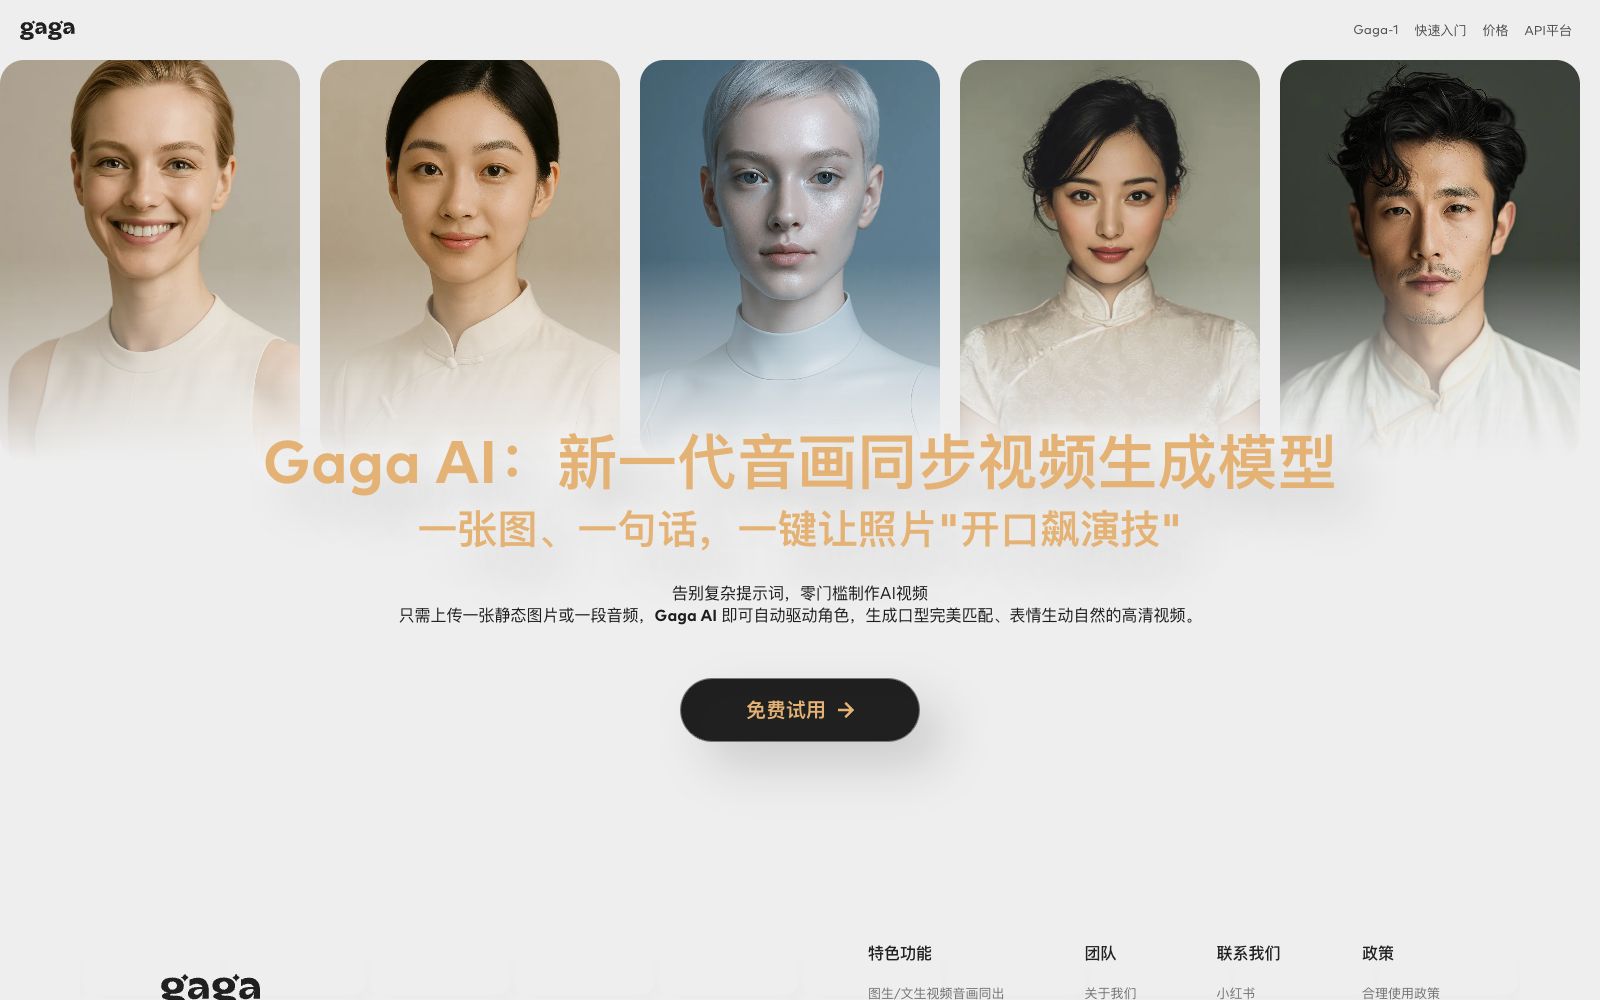
数字人/口播音画同步的视频生成模型,上传一张图片或一段音频即可生成口型精准、表情自然的视频,官方称支持音色复刻、多语种数字人对口型与图片超分。
照片说话口型同步音色复刻
月访问量9.7 万↓16.3%
全球排名#301,728
月访问量为第三方平台估算,仅供参考界面预览
Deep Dive
更新于 2026-11-03详细介绍
Gaga 是一个主打「音画同出」的视频生成模型,官方型号写作 Gaga-1。它把使用门槛压得很低:不用写复杂提示词,上传一张静态图片或一段音频,模型就会驱动画面里的人开口说话,口型跟着音轨走,表情随语气变化。官网把适用场景直接写成真人短剧、数字人播报和短视频 IP 制作。它的短板也明显:擅长单人正面表演,复杂运镜和多人互动仍要靠传统拍摄。
核心能力
- 图生视频与文生视频音画同出:画面与声音在一次生成里对齐,省掉先出画面、再配音、再对口型的拼装流程。同一段素材改台词时不必重配画面,改音轨再跑一次即可。
- 精准口型驱动:官方描述为口型与音轨严格匹配、表情自然,针对的正是「嘴在动但对不上字」这个常见问题。情绪起伏大的台词建议分段生成,单条越长越容易在结尾松掉。
- 音色复刻:可复刻指定音色用于后续配音,适合固定人设的账号保持声音一致性。音色复刻需要一定长度的干净样本,样本太短容易跑调。
- 多语种数字人对口型:同一段表演可换语种输出,官方将其列为数字人出海场景的能力。换语种后先看一遍口型,再决定是否保留原画面。
- 图片超分:对低分辨率素材做清晰度提升,让老照片或压缩过的图也能进入生成流程。超分后再生成,面部细节的稳定性通常更好。
- API 平台:官网设有 API 平台与价格页,可接进自有生产流程批量跑。批量任务走 API 更省事,单条试错仍建议用网页端。
适合谁
- 做真人短剧、单元剧的团队,需要低成本补拍对话镜头。
- 运营虚拟主播、数字人播报账号的团队,每天要出口播内容。
- 做知识科普、课程讲解的创作者,用一张形象图批量出讲解视频。
- 需要给同一角色做多语种版本的出海短剧团队。
使用建议
- 先用免费试用跑一条十秒左右的单人正面镜头,确认口型和表情可接受再批量投入;侧脸、遮挡、快速转头仍是这类模型的难点。
- 输入音频尽量干净、无背景音乐,语速平稳;音色复刻前必须取得声音权利人的书面同意。
- 图片选正脸、光线均匀、嘴部清晰的素材,分辨率不够先做超分,生成稳定性会明显提升。
- 商业发布前核对平台的使用条款与内容政策;真人肖像需授权,AI 生成内容可能涉及标识义务,规则可能调整,投放前再核一次。
- 需要固定人设时,把「形象图 + 音色 + 常用台词风格」打包成一套模板,跨批次生成才不容易跑形。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Gaga 每月约有 9.7 万次访问,在「数字人/口播」55 个同类工具中排第 35 位。全球排名第 301,728 位(新兴站点),近一个月流量下降 16.3%。
月访问量
9.7万
较上月 -16.3%较3月前 -35.9%
跳出率
43.6%
只看一页就离开,越低越好
平均时长
00:11
每次访问的平均停留
次均页数
2.88页
每次访问浏览的页面数
近 12 个月当月 9.7 万
39.8 万
34.8 万
14.1 万
17.7 万
12.0 万
7.8 万
5.9 万
10.8 万
15.2 万
14.6 万
11.7 万
9.7 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 美国8.4%
- 巴西6.1%
- 法国5.8%
- 印度5.0%
- 墨西哥4.9%
流量来源
访客从哪里进来- 直接访问40.5%
- 搜索引擎34.9%
- 外链引荐10.2%
- 社交媒体6.4%
- 邮件2.6%
- 展示广告2.5%
- 其他2.9%
「数字人/口播」内排名低于中位数 46%
第35名
共 55 个同类工具
本工具
9.7 万
中位数
17.9 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考