Mercury
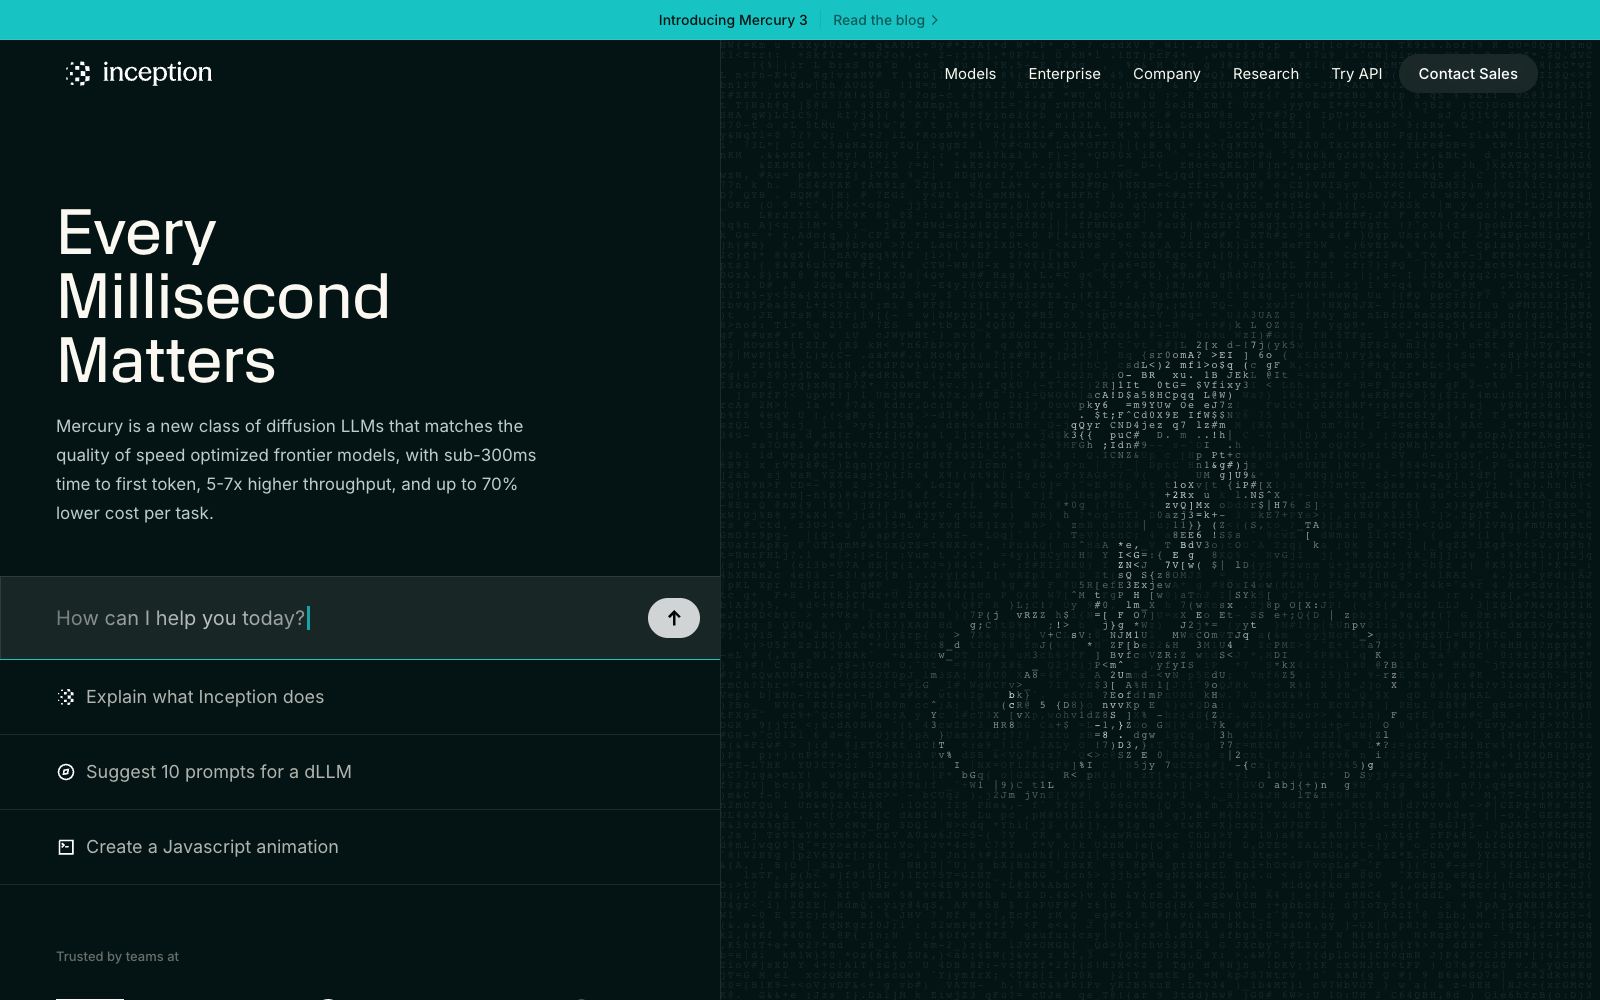
AI编程/编码智能体Mercury 是 Inception 的扩散式大语言模型,并行生成 token,官方称首字延迟低于 300 毫秒、吞吐提升 5-7 倍,适合实时语音、代码补全与高并发智能体。
扩散模型低延迟推理结构化输出
月访问量11.8 万↑165.6%
全球排名#380,880
月访问量为第三方平台估算,仅供参考界面预览
Deep Dive
更新于 2026-11-03详细介绍
Mercury 是 Inception 推出的扩散式大语言模型系列。主流模型逐字往外吐 token,Mercury 改用扩散思路并行生成,官方称因此能做到低于 300 毫秒的首字延迟、5 到 7 倍的吞吐,以及最多低 70% 的单任务成本。团队来自斯坦福、UCLA、康奈尔、Google DeepMind、Meta AI、微软 AI 和 OpenAI,官方称已在财富 500 强企业部署。
核心能力
- 并行解码:官方称扩散模型一次生成多个 token,而非顺序逐字生成,从而提升速度并拉高 GPU 利用率。
- 低延迟:官方称首字延迟低于 300 毫秒,适合实时交互场景。
- 吞吐与成本:官方称吞吐为同类速度优化模型的 5 到 7 倍,单任务成本最多降低 70%。
- 结构化输出:扩散框架对输出有细粒度控制,可遵循指定的结构与语义约束。
- 产品矩阵:Mercury 3 面向复杂推理,输入 $0.10、输出 $0.35 每百万 token;Mercury Voice 首字延迟低于 170 毫秒;Mercury Decide 返回带校准的概率,并支持把没把握的转给人工。
- 接入简单:API 兼容 OpenAI 接口,可作为传统模型的直接替换;同时通过 AWS Bedrock 与 Azure Foundry 提供。
- 企业级保障:官方称提供 99.5% 以上可用性与自定义 SLA,支持微调和私有部署。
适合谁
- 做实时语音客服的团队:首字延迟直接决定对话是否自然。
- 代码编辑器与补全厂商:补全慢半秒,用户就离开心流。
- 高并发智能体平台:吞吐和单任务成本决定毛利。
- 批量分类与路由场景:用 Decide 处理结构化选择,把不确定的转人工。
- 有私有化要求的企业:需要云厂商通道和可用性承诺。
使用建议
- 迁移成本很低:接口兼容 OpenAI,先改地址和模型名跑一轮对比。
- 按场景选型号:实时语音用 Voice,复杂推理用 Mercury 3,二选一的分流用 Decide。
- 结构化任务把 schema 写死,扩散模型对约束的遵循是它的卖点之一。
- 价格页标注了 50% OFF,属于限时折扣,做预算时按原价留余量。
- 先小流量灰度,用你自己的任务测延迟和成本,官方基准不等于你的业务基准。
- 对数据驻留有要求的,走 Bedrock 或 Foundry 并谈私有部署。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Mercury 近一个月流量增长 165.6%,月访问量约 11.8 万,在「AI编程/编码智能体」97 个同类工具中排第 56 位。全球排名第 380,880 位(新兴站点)。
月访问量
11.8万
较上月 +165.6%较3月前 +91.7%
跳出率
29.7%
只看一页就离开,越低越好
平均时长
01:28
每次访问的平均停留
次均页数
2.67页
每次访问浏览的页面数
近 12 个月当月 11.8 万
1.5 万
2.0 万
3.1 万
3.1 万
6.4 万
17.9 万
10.8 万
8.1 万
6.2 万
5.6 万
4.5 万
11.8 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 美国41.6%
- 印度18.8%
- 印度尼西亚7.1%
- 中国3.7%
- 德国2.7%
流量来源
访客从哪里进来- 直接访问56.0%
- 搜索引擎23.0%
- 社交媒体11.6%
- 外链引荐5.7%
- 展示广告2.0%
- 邮件0.7%
- 其他1.0%
「AI编程/编码智能体」内排名低于中位数 42%
第56名
共 97 个同类工具
本工具
11.8 万
中位数
20.4 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考