Groq
模型与算力Groq 自研 LPU 芯片驱动的推理云,以超低延迟运行 Llama、Mixtral 等开源模型,OpenAI 兼容 API 迁移成本低,官方称每周处理数万亿 token。
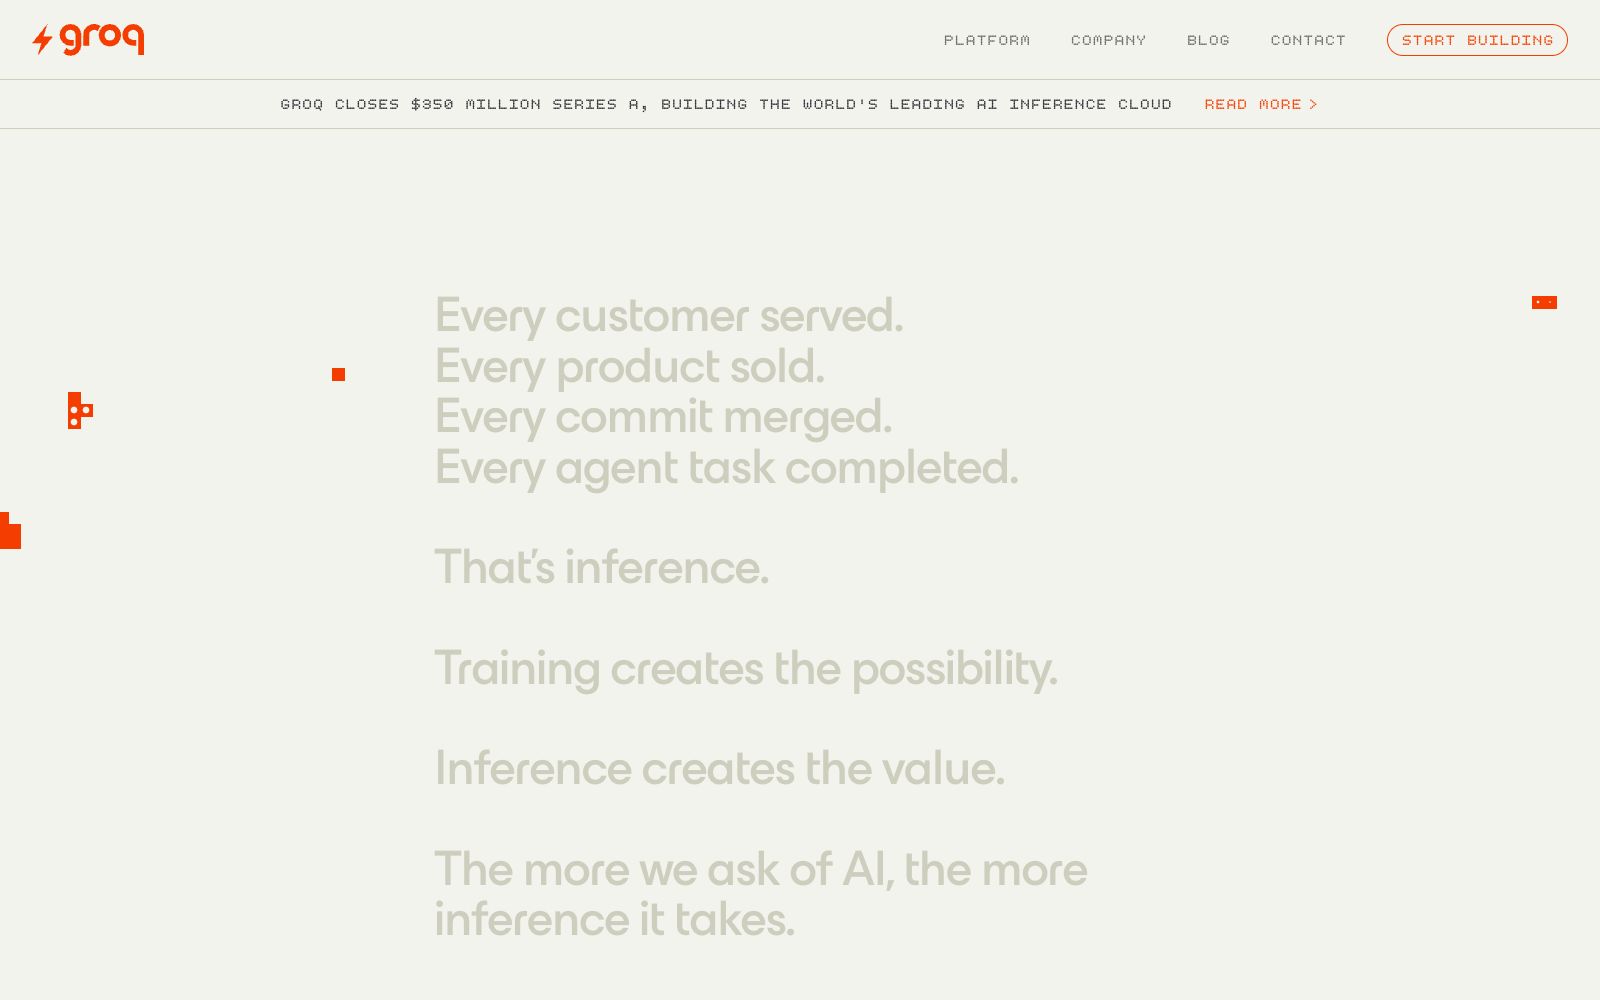
界面预览
详细介绍
快速了解
核心摘要- 是什么
- Groq 是自研 LPU 芯片的推理云服务商,提供低延迟的大模型推理与 API
- 核心能力
- LPU 架构、开源模型托管、OpenAI 兼容 API、LPX 混合方案、实时交互场景、按量计费
- 使用方式
- 自助式 API 开通,无需申请即可调用,多模型可走 OpenAI 兼容接口统一路由
- 是否收费
- 按量计费、自助开通,价格与速率限制以官网最新条款为准
Groq 的叙事很直接:训练创造可能性,推理创造价值,而推理正在成为瓶颈。它自研了 LPU 芯片,如今配合 LPX 与英伟达下一代 GPU 一起提供推理能力,把自己定位成「快速推理的 neocloud」。官方称每周有数百万开发者在 Groq 上运行数万亿 token,并强调「快与便宜不再是二选一」——官方正在建设数百兆瓦的算力容量来支撑这一承诺。对开发者而言,它把「高速推理」从口号变成可用的 API,让实时交互类产品不必在延迟与成本之间做取舍。
核心能力
- LPU 架构:为推理专门设计的芯片,主打低延迟与高吞吐而非通用训练加速,是超低首 token 延迟的根基。
- 开源模型托管:Llama、Mixtral、Whisper 等主流开源模型可直接调用,无需自建推理栈即可上线。
- OpenAI 兼容 API:多数场景改一下 base_url 即可迁移,现有代码与工具链的接入成本很低。
- LPX 混合方案:与英伟达下一代 GPU 协同工作,兼顾速度与规模,把「快」与「大」拼在一起。
- 实时交互场景:极低的延迟天然适合对话式语音、流式输出、Agent 循环等对响应速度敏感的应用。
- 按量计费与快速开通:自助式 API 开通,无需申请即可开始调用,适合从原型到生产的快速验证。
适合谁
对首 token 延迟和吞吐敏感的实时应用开发者,以及希望低成本运行开源模型的团队;需要在大规模并发下保持稳定响应速度、又不想自己运维推理栈的产品。对成本敏感但又不愿牺牲响应速度的聊天与客服类应用,它的价值最直观。
注意事项
- 可用模型范围比通用云平台窄,接入前先确认你要的模型在不在其列表里,别等上线才发现缺模型。
- 官方基准与你的真实场景可能差很远,务必用业务提示词、真实上下文长度和并发量压测。
- 推理服务依赖网络,对延迟敏感的部署要评估链路质量;价格与速率限制政策会调整,规模化前核对最新条款。
- 它主打开源模型生态,强依赖闭源旗舰模型的业务需要额外评估替代方案。
使用建议
延迟是它的强项,但别只看演示数据。先在关键路径上用真实负载压测,对比延迟、吞吐与成本三项指标,再决定是否全量接入;如果业务需要多种模型混用,可通过 OpenAI 兼容接口配合网关做统一路由。另外建议关注官方持续上新的模型列表与 LPX 进展——推理能力会随芯片与模型迭代明显变化,定期复评一次选型结论。把它当作「低延迟推理的首选候选」而非唯一答案,配合多供应商策略更稳妥。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Groq 每月约有 721 万次访问,在「模型与算力」12 个同类工具中排第 4 位。全球排名第 6,087 位(前 1 万),近一个月流量下降 10.0%。
用户地区
访客所在国家 / 地区- 印度21.2%
- 美国16.5%
- 巴西7.2%
- 印度尼西亚3.8%
- 巴基斯坦3.7%
流量来源
访客从哪里进来- 直接访问40.7%
- 搜索引擎36.8%
- 外链引荐11.4%
- 社交媒体6.5%
- 邮件0.9%
- 展示广告<0.1%
- 其他3.5%
所属专题
相似工具
Together AI 是 AI 原生云平台,提供开源模型推理、微调与 GPU 集群,OpenAI 兼容接口迁移方便,官方称推理快 2 倍、成本低 60%、预训练快 90%。
同标签 · 推理