Exa
研究与数据分析面向 AI Agent 的搜索 API,一个端点提供实时网页数据、深度研究与结构化内容,返回带高亮且 token 高效,官方称 50 万+ 开发者基于它构建应用,可免费试用,也支
详细介绍
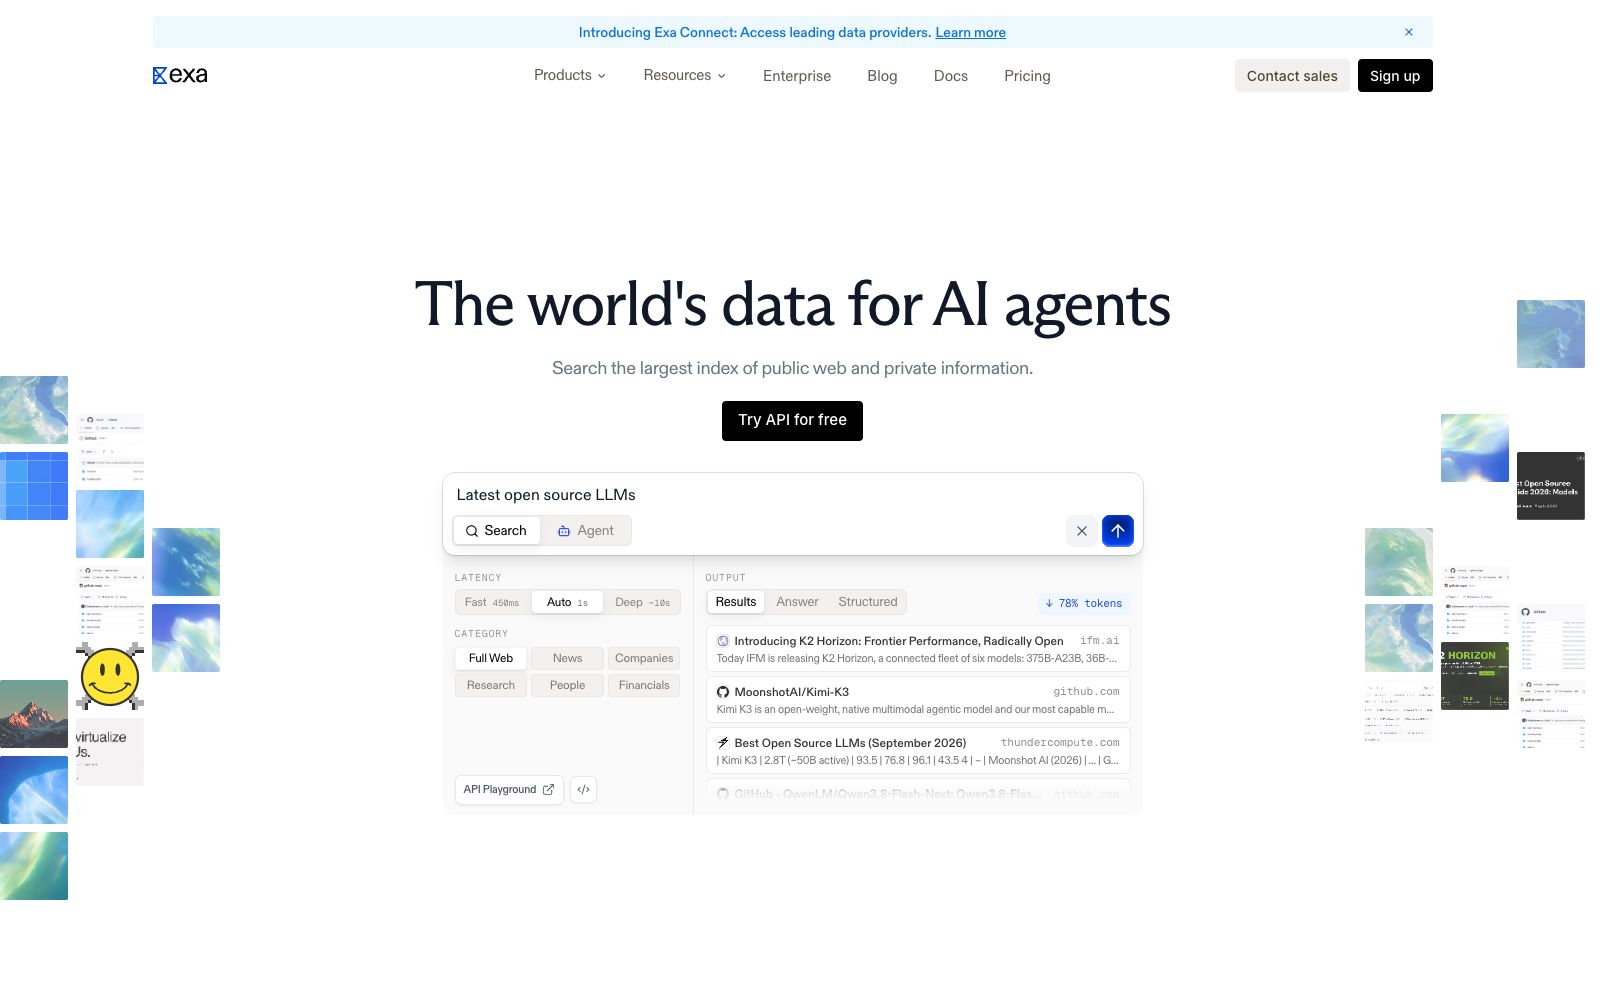
Exa 是一个面向 AI 应用设计的搜索 API,官方定位是「为需要实时网页数据的 AI Agent 提供搜索、深度研究与结构化内容,全部通过一个端点完成」。它的理念是「给 AI 用的搜索」:不是把搜索结果呈现给人,而是把高质量上下文直接喂给模型,让 Agent 更聪明地回答问题。官方称已有 50 万+ 开发者基于它构建应用,从快速检索到深度研究都在同一个 API 内完成,并免费开放试用。搜索 API 并不稀奇,但大多数通用搜索是为「给人看结果页」设计的,返回的 HTML 片段对模型并不友好;Exa 从返回结构上就为 Agent 消费而优化,这是它区别于传统搜索 API 的关键。
核心能力
- 实时网页搜索 API:一个端点覆盖快速检索、深度研究与结构化内容等多种搜索场景,接入简单。
- 面向 Agent 优化:官方称结果经过专门设计,目标是让 Agent 更聪明地利用上下文、给出更准确的回答。
- Token 高效返回:以高亮(highlights)等结构化形式返回内容要点,降低 token 消耗,官方称其「token 高效」。
- 速度与深度兼顾:官方称从低延迟搜索到深度研究都在同一 API 内提供,按场景选择不同档位。
- 编程场景支持:被用于为编码 Agent 提供文档与代码仓库的智能检索,覆盖各搜索垂直领域。
- 企业级能力:官方提供面向企业的安全与管控选项,满足合规要求。
- 自研检索模型:官方称在大规模数据上训练自有检索模型,持续提升结果质量与相关性。
适合谁
开发 AI 应用、需要给模型接实时网页数据的工程师,尤其是做研究型 Agent、问答系统与编程助手的团队;需要合规、可控搜索能力的企业级开发者;以及希望以较低成本把「联网检索」能力做进产品的创业团队。如果你的产品需要「让模型用最新信息回答」——比如时事问答、产品比价、学术快讯——这类场景正是它的主场。
注意事项
- 按调用量计费,接入前务必用与产品场景相近的真实查询评估结果质量与成本,别只按官方示例判断。
- 搜索型 API 的索引更新有时效,引用质量取决于页面收录情况,关键事实建议二次核验。
- 深度研究与低延迟搜索是不同的能力档位,注意区分对应接口与配额,避免用量和成本失控。
- 做 RAG 时建议把它的返回与自有索引结合,纯依赖外部搜索在垂直领域常不够精准,会引入噪声。
- 涉及隐私与合规的行业,注意确认企业版的安全控制与数据使用条款是否满足要求。
- 免费额度有限,正式接入前确认套餐档位与超量计费规则,避免突发流量带来意外账单。
使用建议
先用免费额度跑一批与产品场景相近的真实查询,对比返回质量、延迟与 token 消耗;再设计合理的缓存与降级策略控制成本。对时效性敏感的垂直领域,把它当作实时补充源而非唯一数据源;对编程 Agent 场景,重点验证它对文档与仓库检索的准确度,再决定是否默认启用。上线后持续监控查询失败率与延迟指标,并保留人工抽查样本,确保结果质量没有随索引变化而滑坡。
相似工具

Komo
AI 搜索引擎,提问后检索网页并给出带来源的答案,提供网页、找人、深度研究三种模式,其中 Firsthand 专用于找到能回答 AI 答不了之事的真人,搜索结果可回溯历史。
同标签 · 搜索
秘塔 AI 搜索
无广告的中文 AI 搜索引擎,直接输出带来源的答案,支持全网、学术、文库范围切换,并提供深度研究、上传文件问答与语音输入。
同标签 · 搜索
Groq
Groq 自研 LPU 芯片驱动的推理云,以超低延迟运行 Llama、Mixtral 等开源模型,OpenAI 兼容 API 迁移成本低,官方称每周处理数万亿 token。
同标签 · API

Perplexity
AI 答案搜索引擎,用自然语言提问即可得到带引用来源的结论,支持追问、多种检索模式与上传文档问答,适合需要边查边核对的检索场景。
同标签 · 搜索

Hive Moderation
Hive 是提供内容理解 API 的 AI 平台,官网列出视觉、文本与音频审核、AI 生成图像与视频识别、OCR 与商标名人识别等模型,按调用量计费。
同标签 · API
Fireflies.ai
会议 AI 助手,转写准确率标称 95%,支持 100+ 语言、说话人识别与自动语言检测,自动生成摘要与行动项,并可跨历史会议检索对话。
同标签 · 搜索