Groq
文本生成与编辑Groq 自研 LPU 芯片驱动的推理云,以超低延迟运行 Llama、Mixtral 等开源模型,OpenAI 兼容 API 迁移成本低,官方称每周处理数万亿 token。
界面预览
详细介绍
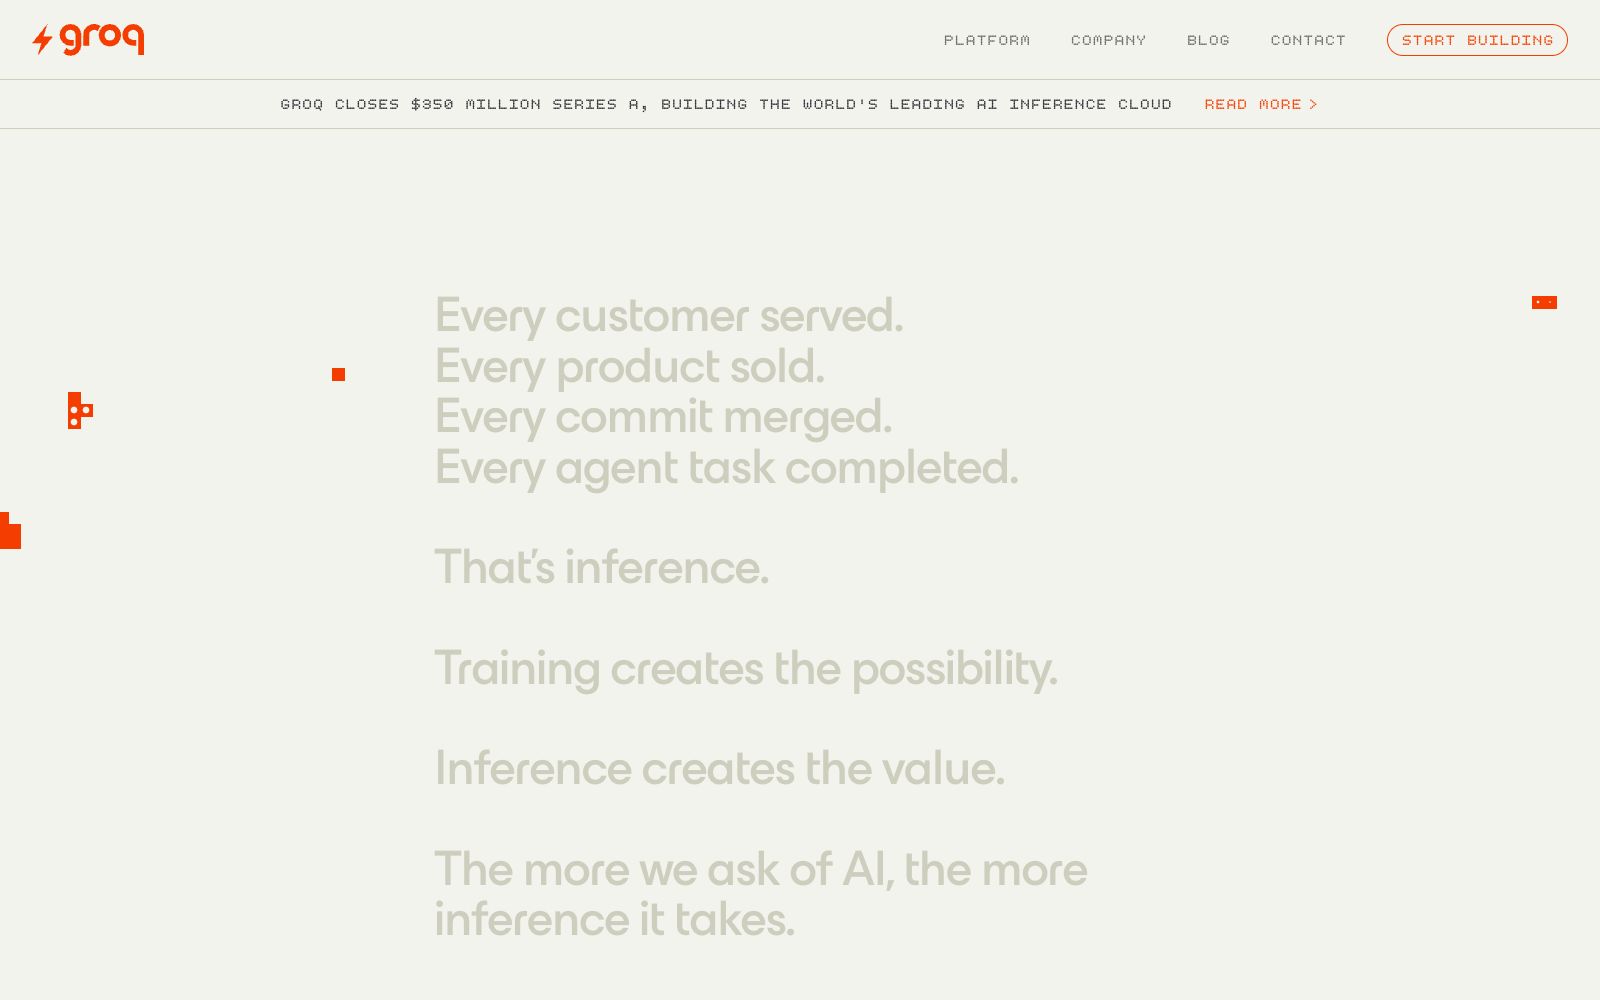
Groq 的叙事很直接:训练创造可能性,推理创造价值,而推理正在成为瓶颈。它自研了 LPU 芯片,如今配合 LPX 与英伟达下一代 GPU 一起提供推理能力,把自己定位成「快速推理的 neocloud」。官方称每周有数百万开发者在 Groq 上运行数万亿 token,并强调「快与便宜不再是二选一」——官方正在建设数百兆瓦的算力容量来支撑这一承诺。对开发者而言,它把「高速推理」从口号变成可用的 API,让实时交互类产品不必在延迟与成本之间做取舍。
核心能力
- LPU 架构:为推理专门设计的芯片,主打低延迟与高吞吐而非通用训练加速,是超低首 token 延迟的根基。
- 开源模型托管:Llama、Mixtral、Whisper 等主流开源模型可直接调用,无需自建推理栈即可上线。
- OpenAI 兼容 API:多数场景改一下 base_url 即可迁移,现有代码与工具链的接入成本很低。
- LPX 混合方案:与英伟达下一代 GPU 协同工作,兼顾速度与规模,把「快」与「大」拼在一起。
- 实时交互场景:极低的延迟天然适合对话式语音、流式输出、Agent 循环等对响应速度敏感的应用。
- 按量计费与快速开通:自助式 API 开通,无需申请即可开始调用,适合从原型到生产的快速验证。
适合谁
对首 token 延迟和吞吐敏感的实时应用开发者,以及希望低成本运行开源模型的团队;需要在大规模并发下保持稳定响应速度、又不想自己运维推理栈的产品。对成本敏感但又不愿牺牲响应速度的聊天与客服类应用,它的价值最直观。
注意事项
- 可用模型范围比通用云平台窄,接入前先确认你要的模型在不在其列表里,别等上线才发现缺模型。
- 官方基准与你的真实场景可能差很远,务必用业务提示词、真实上下文长度和并发量压测。
- 推理服务依赖网络,对延迟敏感的部署要评估链路质量;价格与速率限制政策会调整,规模化前核对最新条款。
- 它主打开源模型生态,强依赖闭源旗舰模型的业务需要额外评估替代方案。
使用建议
延迟是它的强项,但别只看演示数据。先在关键路径上用真实负载压测,对比延迟、吞吐与成本三项指标,再决定是否全量接入;如果业务需要多种模型混用,可通过 OpenAI 兼容接口配合网关做统一路由。另外建议关注官方持续上新的模型列表与 LPX 进展——推理能力会随芯片与模型迭代明显变化,定期复评一次选型结论。把它当作「低延迟推理的首选候选」而非唯一答案,配合多供应商策略更稳妥。
所属专题
相似工具
Together AI
Together AI 是 AI 原生云平台,提供开源模型推理、微调与 GPU 集群,OpenAI 兼容接口迁移方便,官方称推理快 2 倍、成本低 60%、预训练快 90%。
同标签 · 推理

OpenAI Codex
OpenAI 面向代码场景的能力与开发文档入口,开发者可从这里创建 API Key、安装 SDK 跑通首次调用,并了解智能体构建与多模态模型选型。
同标签 · API
DeepSeek 深度求索
DeepSeek 是深度求索的大模型系列,官方开源 V4、R1 等前沿模型,提供网页版、手机应用与开放 API,主打高性价比与原生多模态视觉理解能力。
同标签 · 推理
Exa
面向 AI Agent 的搜索 API,一个端点提供实时网页数据、深度研究与结构化内容,返回带高亮且 token 高效,官方称 50 万+ 开发者基于它构建应用,可免费试用,也支
同标签 · API

Zed
Zed 是 Atom 与 Tree-sitter 作者打造的高性能多人代码编辑器,用 Rust 编写、支持 AI 代理并行编辑与内联助手,可团队实时协作,适合追求速度与协作开发者。
同标签 · 高性能
悟声 AI
超拟真 AI 语音合成与瞬时克隆平台(原 Reecho 睿声),官方称自研文生语音模型支持 30+ 语言与方言,最短 3 秒样本即可克隆声音,并提供声音市场与低延迟 API。
同标签 · API