LLM Stats
研究分析把 300 多个 AI 模型的智能水平、速度与价格折算成单一综合分的独立榜单,数据持续从公开基准与真实 API 指标更新,支持多任务维度排行。
界面预览
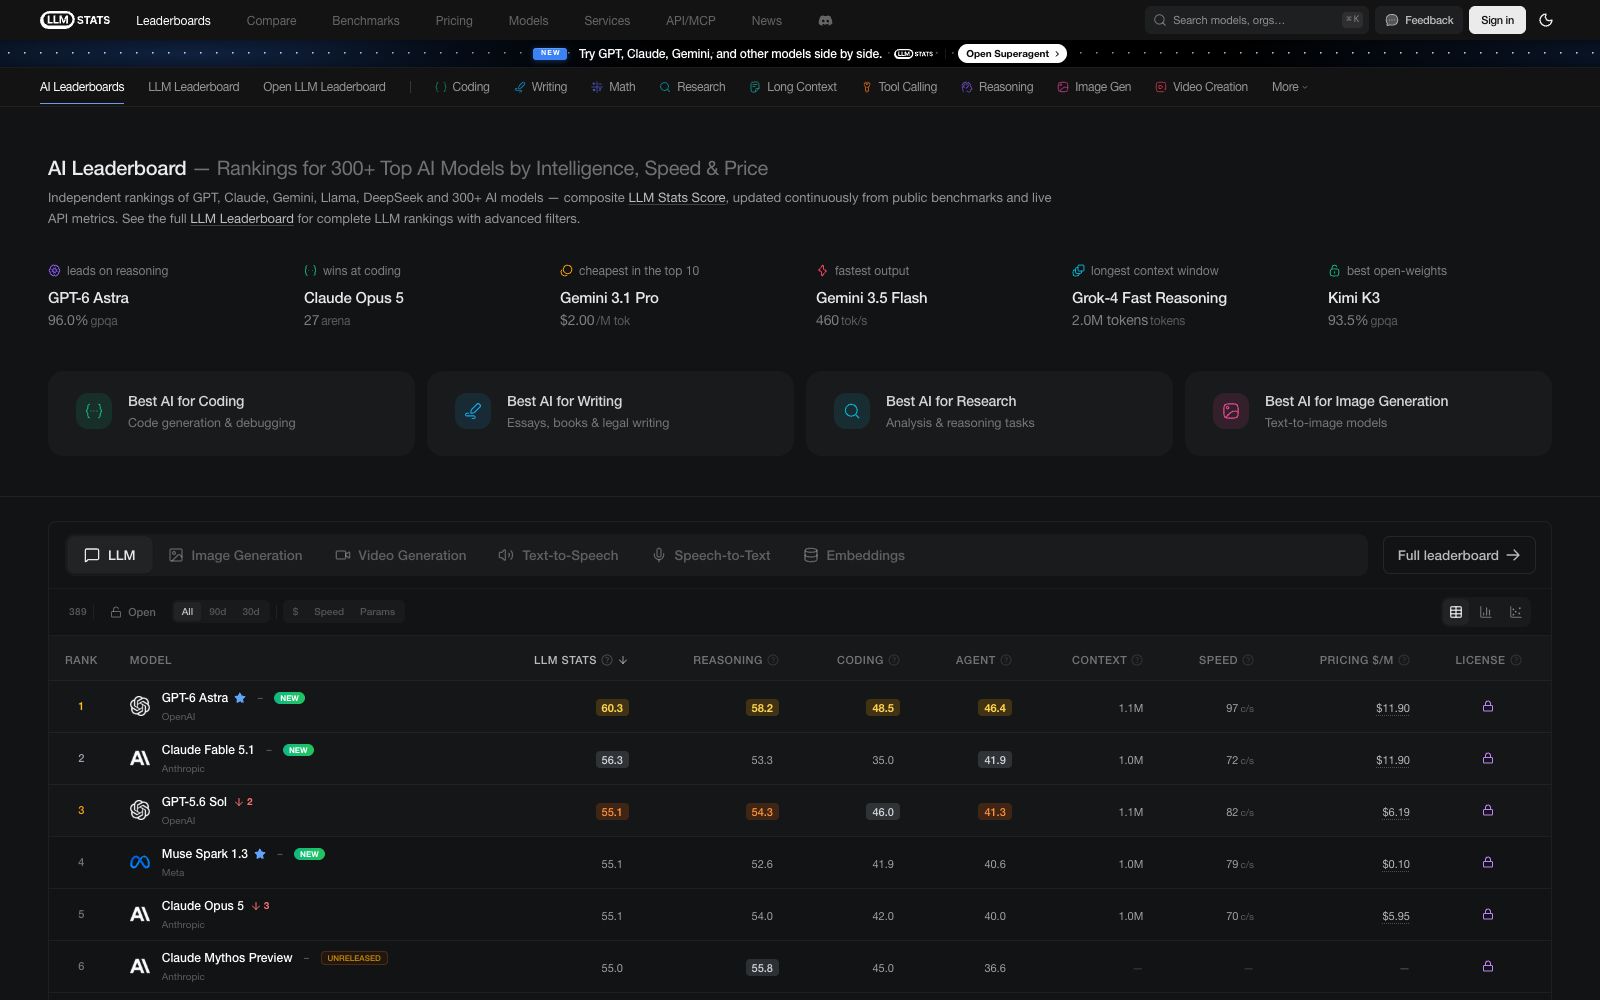
详细介绍
快速了解
核心摘要- 是什么
- 把模型评测压缩成单一综合分的榜单站,覆盖三百多个模型并持续更新
- 核心能力
- 单一综合分、多维榜单、开源模型分榜、持续更新、配套资源
- 使用方式
- 在网站按综合分与分榜筛选模型,再自行对比测试
当市面上的模型评测榜各有各的口径时,LLM Stats 的做法是把「选哪个模型」压缩成一个可比的单一分数。它覆盖 GPT、Claude、Gemini、Llama、DeepSeek 等 300 多个模型,用自建的 LLM Stats Score 综合智能、速度与价格三个维度,数据来源是公开基准加上实时 API 指标,而不是厂商自报,官方定位为独立、持续更新的 AI 排行榜,页面直接给出「用一个独立分数给最好的 AI 模型排名」的承诺。
核心能力
- 单一综合分:把智能、速度、价格等多个维度折算成一个 LLM Stats Score,省去逐项比表的麻烦,快速判断模型的整体水位与相对位置。
- 多维榜单:除总榜外,按编码、写作、数学、研究、长上下文、工具调用、推理、图像生成、视频生成等任务分榜,覆盖主流应用方向,方便按场景筛选。
- 开源模型分榜:单独列出开放权重模型的排名,方便评估可自部署、可控成本的选项,满足对数据主权有要求的团队。
- 持续更新:新模型上线后会进入榜单,并实时吸收 API 侧的速度与价格变化;页面提供新模型列表与性能指数,便于追踪最新发布。
- 配套资源:同时提供竞技场与基准数据入口,便于在单一分数之外做交叉验证,了解不同评测体系下的表现,也可实际对战测试模型,把主观体验与客观分数互相印证。
适合谁
做模型选型的工程与产品团队,需要快速判断「现在最强的是哪个」的从业者,写行业分析要引用排名数据的作者,以及想跟踪开源模型进展、评估自部署方案的开发者。
注意事项
综合分适合快速缩小候选范围,但各维度的权重是榜单方设定的,未必贴合你的具体场景;价格与速度来自实时 API 指标,会随各家定价调整而波动;公开基准数据可能存在发布滞后,对新模型的能力评估未必及时。引用排名数据时建议注明数据口径与更新时间,避免把某一时刻的排名当成永久结论。
使用建议
先用综合分锁定一个候选区间,再按自己最关心的分榜(例如编码、长上下文或推理)做第二轮筛选;实际接入前,最好用自己真实的 prompt 集做一次小规模对比,因为综合分代表平均水平,不代表在你场景里的表现。关注成本的话,可定期查看价格相关指标——模型降价后,性价比排名常会明显变化,综合分榜单能帮你及时捕捉这类机会;新模型密集发布期建议每周查看一次,及时掌握排名变化。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
LLM Stats 每月约有 54.6 万次访问,在「研究分析」50 个同类工具中排第 9 位。全球排名第 104,333 位(新兴站点),近一个月流量下降 1.2%。
用户地区
访客所在国家 / 地区- 美国22.6%
- 中国8.7%
- 德国5.7%
- 印度5.1%
- 法国3.9%
流量来源
访客从哪里进来- 搜索引擎54.8%
- 直接访问36.3%
- 外链引荐5.2%
- 社交媒体1.9%
- 邮件0.6%
- 展示广告0.1%
- 其他1.0%
相似工具
由 Y Combinator 校友团队打造的 AI 聚合平台,一个订阅可用 100 多个模型,并配图像、视频、网站与幻灯片四类创作工作室,官方称支持同题对比与共识答案。
同标签 · 模型对比