
Hume AI
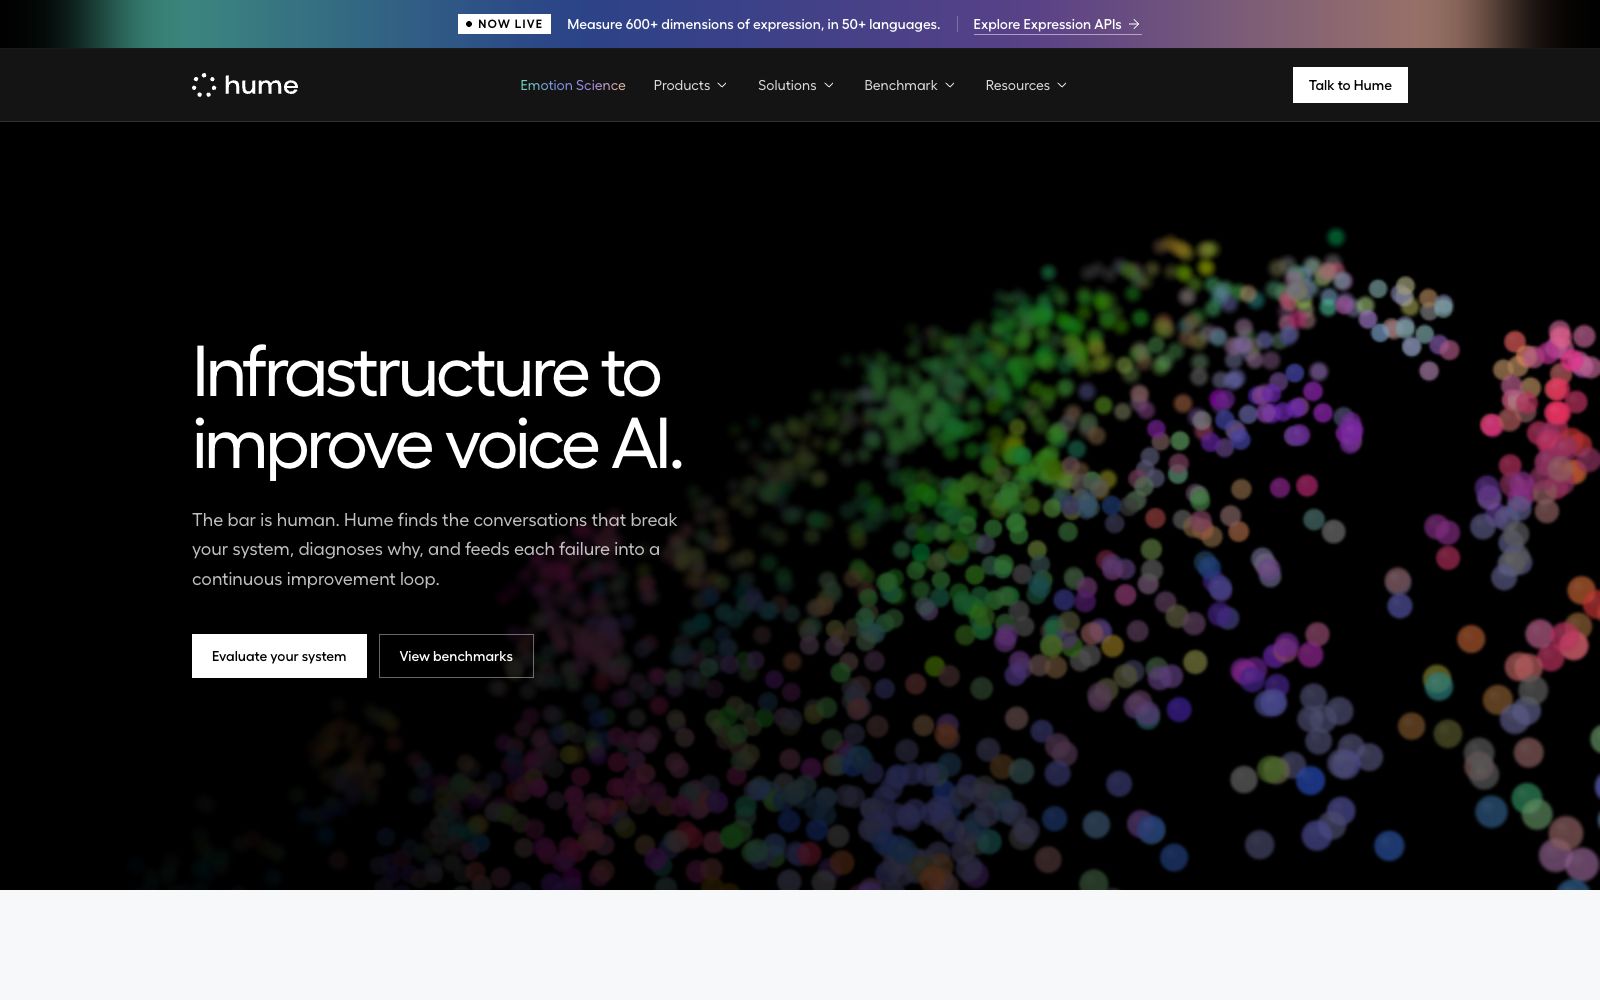
TTS/配音Hume AI 是面向语音模型的评测基础设施,官方称可测 600 多个表达维度,从语气、停顿、情绪到抢话与口音,帮团队找出语音助手在真实通话里失败的地方。
语音评测情感识别对话质检
月访问量8.8 万↑5.6%
全球排名#413,206
月访问量为第三方平台估算,仅供参考界面预览
Deep Dive
更新于 2026-11-03详细介绍
Hume AI 卖的不是语音合成,而是判断语音好不好的标准。官方把问题说得很直白:任务完成了,对话仍可能失败——人评判一段语音时看的是语气、时机、情绪、打断、口音、上下文与适应能力,而这些在转写文本里全丢了。它做的事是把这些维度变成分数,再把失败样本送回改进流程。官方称有 10 年以上情绪科学研究积累、1 亿条以上语音样本,7 家头部 AI 实验室中有 5 家在用。
核心能力
- VoiceEQ 评测平台:从真实对话数据里自动抽取用例、生成测试集、定义场景与成功标准,流程是生成、压测、诊断、验证四步闭环。
- 多维测量:官方称可测 600 多个表达维度、支持 50 多种语言;页面示例把一段对话拆成语气、时机(重叠率与间隔毫秒)、情绪(挫败 0.92)、抢话次数、背景噪声信噪比、口音、语境、适应轮次与意图。
- 公开榜单:Real-World VoiceEQ 对 GPT-4o Realtime、Gemini Live、Hume Octave、ElevenLabs v3、Cartesia Sonic 等做横向对比,维度含表达力、自然度、轮次衔接、语境得体与转写准确率。
- 数据管线(Prism):把非结构化音频整理成可检索、带表达标注的训练与评测输入。
- 表达接口:单独调用即可测量语气、时机与会话动态,不必整套接入。
- 人工反馈接口:接入经过培训与筛选的评估员,给那些只有人能感知的维度打分。
适合谁
- 语音模型团队:TTS、语音转语音、ASR 与级联系统都要在同一把尺子下比较。
- 客服与呼叫中心:语音助手正式上线前,需要知道它在真实来电里会在哪一句崩掉。
- 医疗、保险、金融等强监管行业:通话质量要可追溯、可复议。
- 产品团队:在几个模型之间选型,需要的是可复现的证据而不是演示视频。
- 研究机构:评测口径要写进论文,最好能引用公开方法论。
使用建议
- 先定义什么叫好:同一套指标在客服和金融场景权重完全不同,先写清成功标准再跑评测。
- 用真实录音建测试集,别用录音棚素材,噪声、口音、抢话才是失分点。
- 自动分与人工分一起看:官网示例里医疗场景自动分 0.84、人工分 0.76,差距本身就是信息。
- 注意榜单标注:页面明确写了示例数据仅作说明、并非真实测量结果,引用前先取正式报告。
- 通话录音含个人信息,上传前确认数据留存、地域与脱敏条款。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Hume AI 近一个月流量增长 5.6%,月访问量约 8.8 万,在「TTS/配音」66 个同类工具中排第 42 位。全球排名第 413,206 位(新兴站点)。
月访问量
8.8万
较上月 +5.6%较3月前 -3.4%
跳出率
43.2%
只看一页就离开,越低越好
平均时长
01:50
每次访问的平均停留
次均页数
4.21页
每次访问浏览的页面数
近 12 个月当月 8.8 万
26.6 万
19.3 万
18.0 万
16.6 万
15.0 万
14.5 万
11.7 万
9.0 万
9.1 万
9.8 万
8.4 万
8.8 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 美国32.3%
- 印度8.9%
- 孟加拉国5.7%
- 埃及5.5%
- 德国3.1%
流量来源
访客从哪里进来- 搜索引擎42.6%
- 直接访问37.9%
- 社交媒体8.0%
- 外链引荐5.3%
- 展示广告0.8%
- 邮件0.6%
- 其他4.9%
「TTS/配音」内排名低于中位数 45%
第42名
共 66 个同类工具
本工具
8.8 万
中位数
16.0 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考