Arena
研究与数据分析众包模式的 AI 模型竞技场,两个模型匿名对战由用户投票分胜负,并据此生成 LLM、图像与代码模型的公开排行榜,内置落地页、仪表盘、小游戏等任务模板可直接实测。
详细介绍
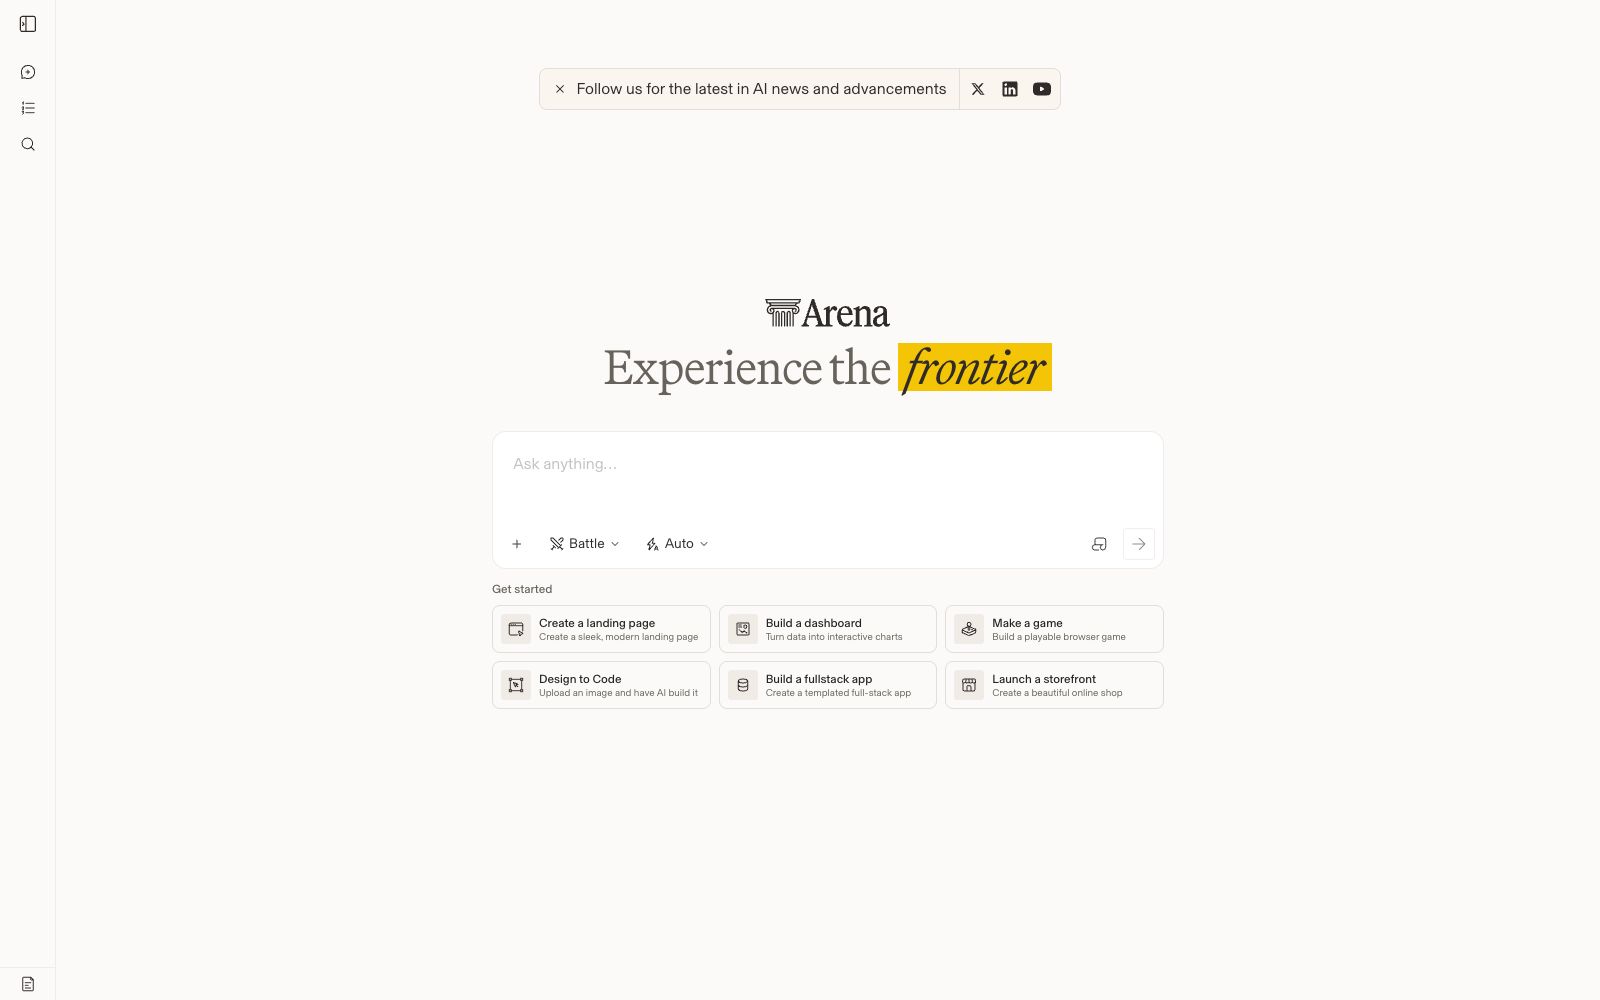
Arena(arena.ai)是主打「用户投票定排名」的 AI 模型竞技场与排行榜平台,官网自称官方 AI 排名与 LLM 排行榜。它把「哪个模型更好」的判断权交给真实使用者:同一个提示词同时发给两个匿名的模型,由你投票选出更优的回答,投票结果汇入由社区共同塑造的公开排行榜。平台覆盖 LLM、图像与代码三类模型,通过真实世界评测持续更新排名,并提供多种任务模板,让选型前的实测不必从零写提示词。
核心能力
- 匿名对战(Battle Mode):两个模型以匿名身份作答,投票时不展示品牌,结果更贴近回答质量本身而非厂商光环,避免先入为主的偏见。
- 公开排行榜:社区投票持续累积,形成 LLM、图像与代码模型的分项排名,持续由真实世界评测驱动更新,而非厂商自报数据。
- 任务模板:内置创建落地页、搭建仪表盘、做可玩小游戏、Design to Code(上传图片让 AI 把它构建出来)、构建全栈应用、开设网店等常用模板,一键发起对比。
- 文件输入:支持给对话附加文件,把真实素材带进对比场景,让评测更接近实际使用。
- 前沿体验:官网口号是「体验前沿」(Experience the frontier),可直接在页面里跑一遍各家最新模型,直观感受能力差异。
适合谁
需要挑模型但不想只看官方跑分的开发者与产品团队;想直观感受各家模型能力差异的普通用户;要给团队或客户解释「为什么选这个模型」的决策者。投票门槛低,对不熟悉基准测试术语的非技术用户也友好,但网站交互以英文为主,需要一定的英文阅读能力。
使用建议
投票榜反映的是「多数人更喜欢」,不完全等于客观能力,长尾任务上可能有偏差。建议把排行榜当筛选器:先用内置任务模板在接近自己场景的提示词上跑一轮,比较回答质量后再缩小候选范围;对结果差异不明显的模型,可用同一提示词多投几次观察稳定性。不同任务类型(写代码、写文案、做图)的最优模型可能不同,建议按自己的高频场景分开对比,也留意榜单里没关注过的黑马模型。最终选型结论,请结合自己的真实任务再验证一轮。
注意事项
排行榜由社区投票驱动,参与者的构成与投票数量会影响排名,特定领域的结论需谨慎引用;榜单名次随投票持续变动,引用时请注明查看时间;匿名对战只能覆盖公开可访问的模型,私有或未开放评测的模型不会出现在榜单上;投票反映普遍偏好,涉及专业、垂直任务的选型仍应结合自己的实测数据,不要仅凭名次做决定。
相似工具
imgsys
fal.ai 推出的生成图像模型竞技场,用同一提示词对比不同模型出图,按用户投票给出人气排名并标注样本量,覆盖商业与社区模型,可直接在线试玩。
同标签 · 竞技场
LLM Stats
把 300 多个 AI 模型的智能水平、速度与价格折算成单一综合分的独立榜单,数据持续从公开基准与真实 API 指标更新,支持多任务维度排行。
同标签 · 排行榜
SEAL LLM Leaderboard
Scale AI 旗下 Labs 出品的专家驱动评测榜单,覆盖智能体编程、前沿推理与安全对齐等 20 多个基准、100 多个模型,可按能力维度分档浏览并持续更新。
同标签 · 排行榜
OpenRouter LLM Rankings
按真实调用量排名的 LLM 使用榜单,基于开发者通过 OpenRouter API 处理的 token 数统计,提供任务、成本与市场份额等多维排名,反映生产环境的真实选择。
同标签 · 排行榜

PromptPilot
火山引擎推出的提示词工程平台,官方称覆盖提示词生成、调试与批量评估,支持文本理解、视觉理解与多轮对话等场景,可上传任务数据自动优化提示词并通过 API 调用。
同标签 · 模型评测

Poe
Quora 旗下 AI 聊天聚合平台,在一个界面里与 GPT、Claude、Gemini、Grok、Kimi 等数千个模型私聊或群聊,无需订阅各家服务,适合横向对比模型回答质量。
内容相近