Agentset
代码编程与辅助Agentset 是开源 RAG 与智能体构建平台,几分钟搭出生产级问答应用:多模态解析图片图表表格、自动引用来源、支持元数据过滤与自托管,基准测试表现领先。
详细介绍
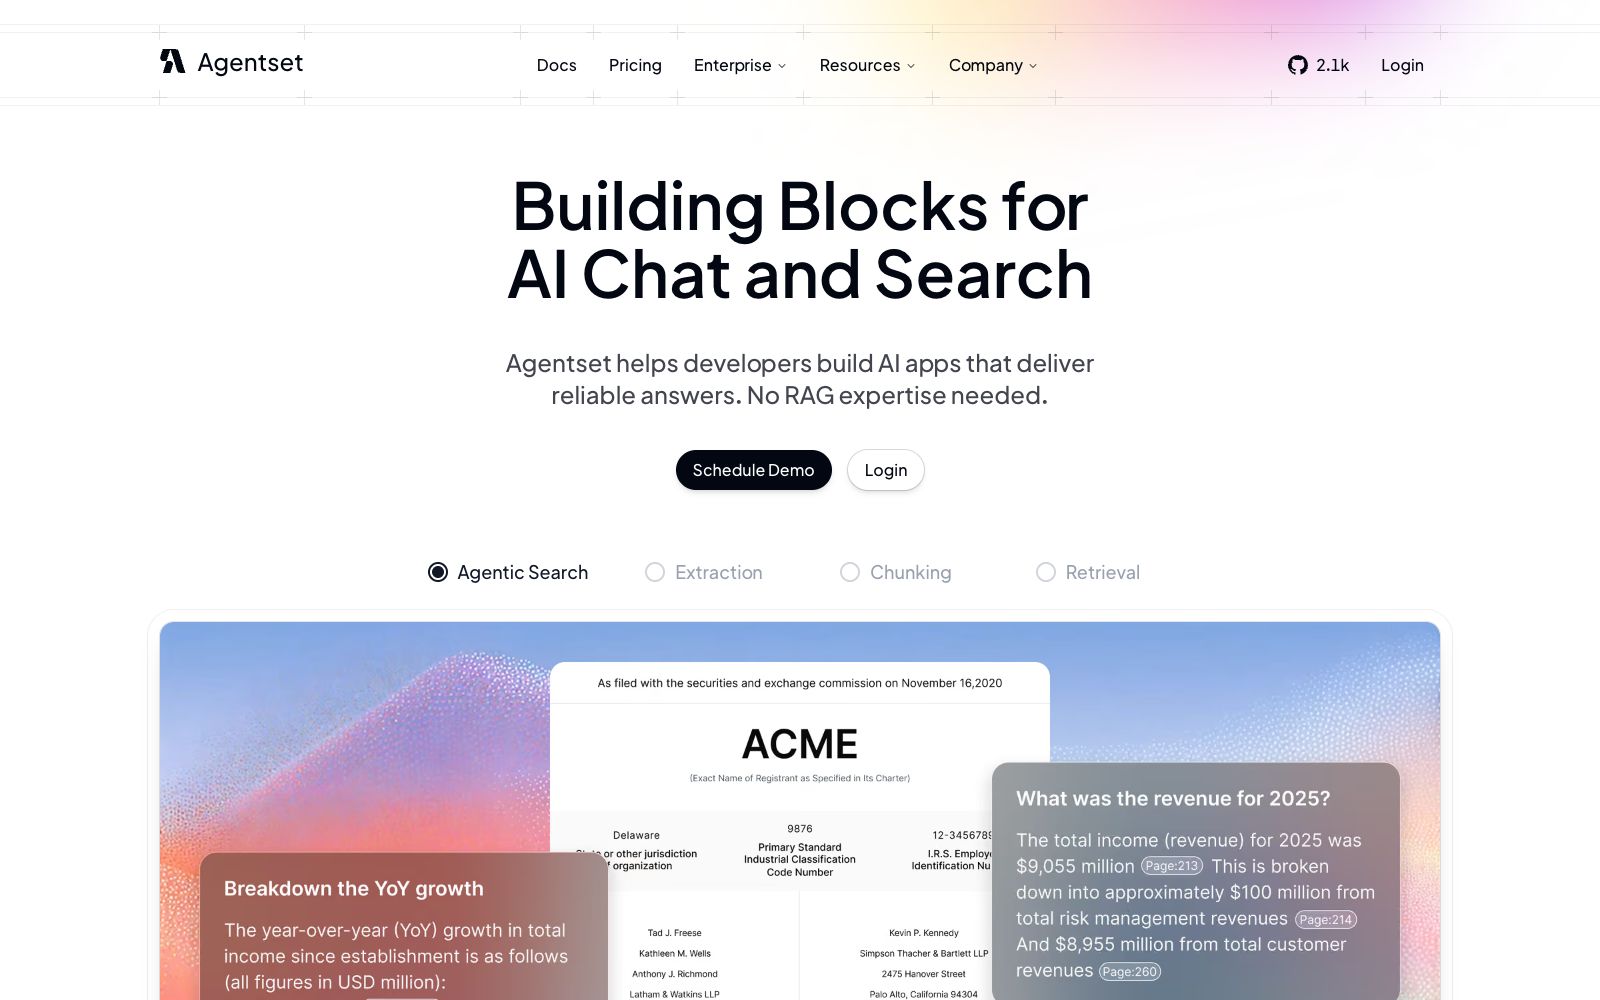
Agentset 的卖点是「不用专业知识也能在几分钟内做出生产级 RAG」。它把自己定位成构建 AI 问答与搜索应用的开放平台,强调可靠答案与更少的意外,官方称在 MultiHopQA 多跳问答与 FinanceBench 金融基准上达到了业界标杆水平。它处理的不只是干净文本——图片、图表、表格都能像文本一样参与检索与回答,让知识库的每个角落都可用。对中小团队来说,它试图把「检索质量」这件过去靠专家调优的事,变成平台默认就做好的事情。
核心能力
- 高准确率检索:官方称在做任何定制之前,对自有数据已有很好的准确度,开箱即用、省去大量调优。
- 多模态解析:原生支持图片、图表与表格,可从知识库的任意部分回答问题,而不只是纯文本段落。
- 自动引用:回答自动标注来源,用户可自行核查,官方称这是提升信任的关键设计。
- 过滤与权限:支持元数据过滤,可按租户、部门或文档子集圈定答案范围,适配多租户与权限隔离。
- 可自托管:开源版本可部署在自己的基础设施上,与现有技术栈和治理要求兼容。
- 不是框架:官方明确区别于 LangChain、LlamaIndex 这类框架,定位更偏开箱即用的平台,FAQ 里直接回答了「为什么不自己造」。
- 开发体验友好:官方强调 Built for developers,提供清晰的构建块与开发者工具,接入顺畅。
适合谁
想快速上线内部知识库问答或搜索、又不想投入大量调优人力的团队;对数据合规要求高、需要自托管的企业同样适用;也适合作为「先跑通再扩展」的起步方案,以及预算有限、不想为每个功能模块单独选型拼装的团队。
注意事项
- 基准成绩来自特定评测集,真实效果取决于你的文档质量与问题分布,务必用真实资料验证,别拿示例数据下结论。
- 多模态解析对扫描件、复杂版式文档的识别效果需实测,不能只看宣传;图片中的内容可能不如文本好检索。
- 开源版与商业版在功能、支持与更新节奏上可能有差异,部署前确认版本边界与许可证。
- 自托管需要自己承担基础设施与运维成本,规模大了要考虑索引与检索性能。
- 平台封装了较多实现细节,深度定制或对检索链路有特殊要求的场景,灵活性可能不如自己写。
使用建议
真实文档(扫描件、表格、图表)才是它的分水岭,评估时别只拿干净的 Markdown 测。官方 FAQ 里对「为什么不自己造」有正面回答,选型讨论时可以直接引用。先圈定一个高频问题域试跑,验证准确率与引用质量后,再逐步放开到全库;上线后持续监控「引用是否被点击核查」这类信号,能侧面反映答案可信度,及时调整数据源与权限配置。
相似工具
Haystack
deepset 维护的开源 AI 编排框架,用模块化组件搭建可上生产的智能体、检索增强与语义搜索系统,每一步都可检视、调试与替换。
同标签 · RAG / 开源
LlamaIndex
以文档智能为核心的 AI 数据框架,旗舰能力 LlamaParse 用智能体式 OCR 把带复杂表格、图表的文档解析成 AI 可用的结构化上下文。
同标签 · RAG
Langfuse
开源(MIT)的 LLM 工程平台,把追踪、评估、提示词管理与数据集整合一处,基于 OpenTelemetry,用生产数据持续改进 AI 应用,可自托管。
同标签 · 开源
Vanna.ai
开源 SQL 智能体框架,让不懂 SQL 的用户用自然语言查询公司各业务系统,内置用户级权限、配额管理、现成 UI 组件,支持多数据库与多轮对话。
同标签 · 开源
Devin
Devin 是 Cognition 推出的自主 AI 软件工程师,并行云端处理跨仓库工程任务:PR 审查与视觉 QA、代码迁移重构、Issue 分诊、文档生成,还能学会你的代码库。
同标签 · Agent
Continue
开源 AI 代码助手项目,主打接入任意模型自定义补全与对话;团队已被 Cursor 收购,开源代码库仍可自由获取,可自行部署与改造。
同标签 · 开源