Langfuse
代码编程与辅助开源(MIT)的 LLM 工程平台,把追踪、评估、提示词管理与数据集整合一处,基于 OpenTelemetry,用生产数据持续改进 AI 应用,可自托管。
详细介绍
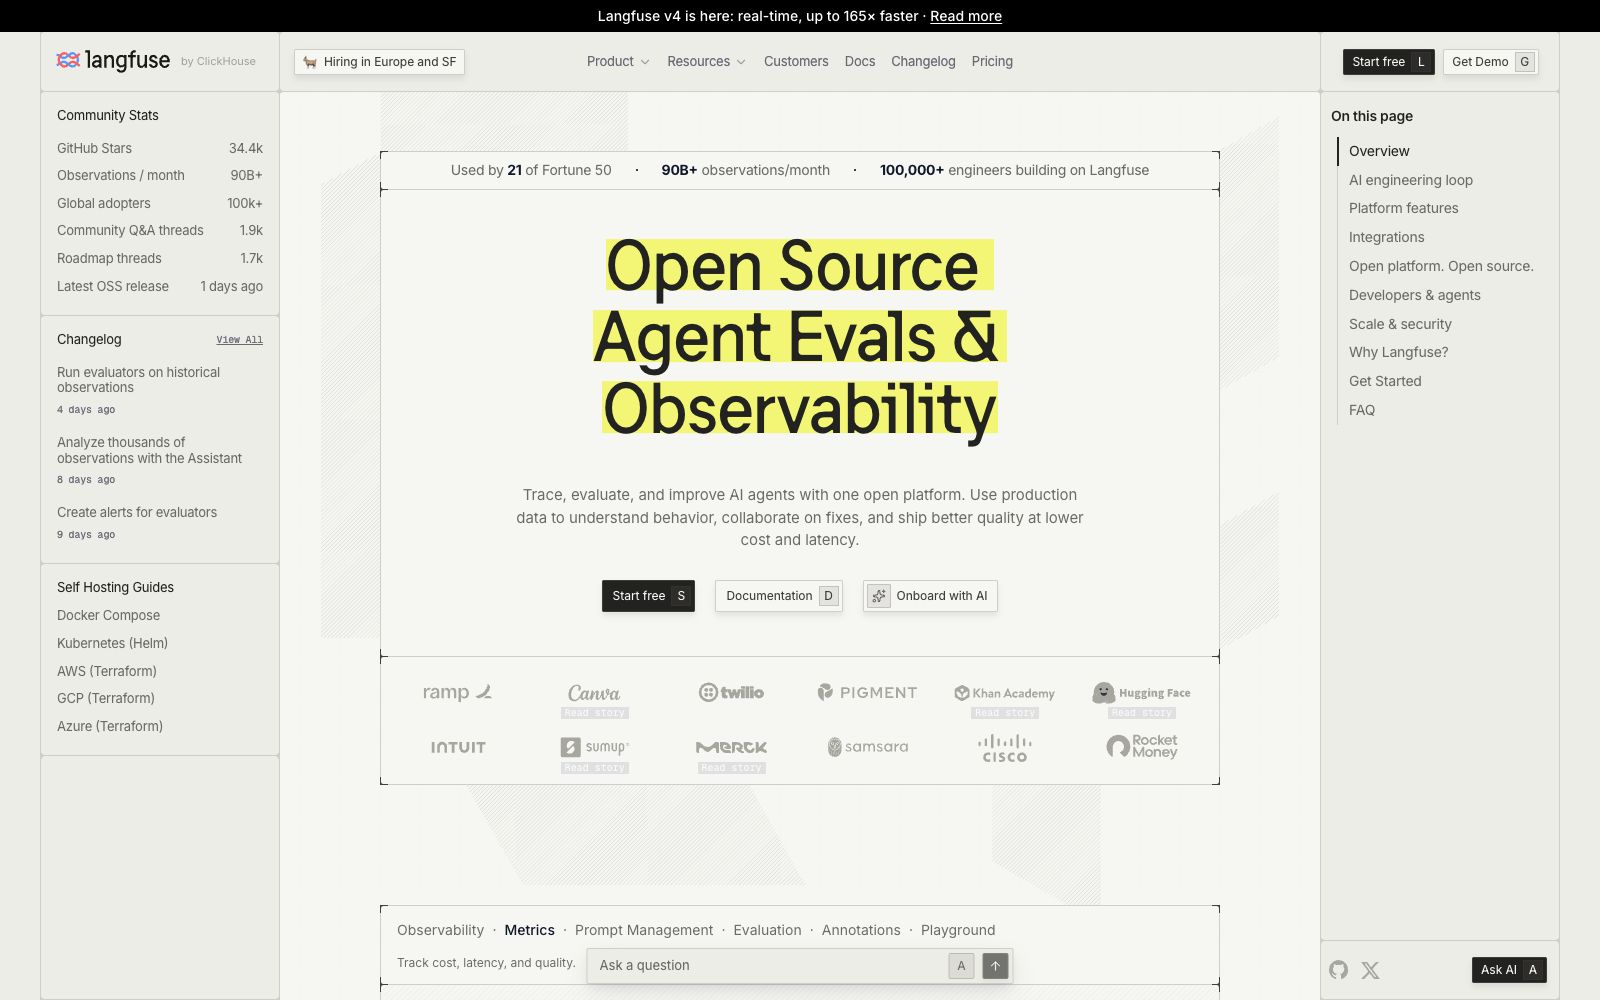
Langfuse 是开源(MIT)的 LLM 工程平台,官方定位是「追踪、评估并改进 AI Agent」的开放平台(Open Source Agent Evals & Observability)。它的做法是先记录线上真实请求,再用这些生产数据理解行为、协作修复问题,从而以更低的成本和延迟交付更高质量的版本,官方把这一循环概括为「Launch, observe, improve — repeat」(上线、观察、改进,循环往复)。官方披露有 21 家财富 50 强企业使用,月处理观测数据超过 900 亿条,10 万+ 工程师在其上构建;官方还称它「为开发者而生、也被 Agent 喜爱」(Made for developers, loved by agents),生产验证充分。
核心能力
- 全链路追踪:完整记录 LLM 调用、工具调用与 Agent 步骤,配合指标(Metrics)看清每次请求的行为、延迟与成本,快速定位问题。
- 评估体系:支持数据集回归、LLM-as-a-judge 与人工标注评分(Annotations),把「好不好」变成可量化的指标。
- 提示词管理:提示词版本化、对比与回滚,与代码解耦;内置 Playground 方便调试与实验。
- OpenTelemetry 原生:基于 OTel 标准采集,兼容 100+ 集成,官方强调可对接任何技术栈(Works with any stack)。
- 自托管或云:开源版可自行部署,数据留在自己手里;异步默认(Async by default),能支撑高吞吐的生产负载。
适合谁
把 LLM 应用推上生产、需要可观测与评估闭环的工程团队;对数据合规要求较高、倾向自托管的企业;以及要统一管理多个 LLM 应用、建立组织级观测平台的技术团队。
注意事项
- 追踪与评估本身有学习曲线,团队需要投入时间把埋点做对,否则数据不完整。
- 云版会经第三方处理调用数据,敏感场景请评估自托管方案与数据驻留条款。
- 评估指标的质量取决于标注与数据集设计,偷懒的评估比没有评估更容易误导决策。
- 高吞吐场景下大量观测数据会带来存储成本,注意采样与保留策略。
- 评估与标注需要人力投入,先聚焦核心链路的高价值用例,别一上来追求全覆盖。
- 自托管部署需要维护基础设施,团队规模小时云版免费层可能已经够用。
- 埋点覆盖不全时追踪图会缺环节,排查问题前先确认相关调用都已接入。
- 评估结果要定期回看,长期不更新的指标会逐渐失真,难以反映线上真实表现。
使用建议
先接追踪看清真实流量与失败模式,再建评估数据集做回归,最后才动提示词优化——顺序反了容易在噪声上做判断。评估用例建议从真实失败请求里挑,比凭空造的好用;团队协作时把标注、修复与回滚闭环跑起来,平台价值才能真正显现。官方还提供 AI 助手(Langfuse Assistant)辅助接入与排查,遇到埋点问题可先走这条路;即使只接入少量关键应用,也能立刻获得清晰可见的调用与失败视图。
所属专题
相似工具

Phoenix
Phoenix 是 Arize 开源的 Agent 开发与评估平台:可视化每一步调用、用实验证明改动有效,一条命令本地启动,可自托管,让 Agent 质量提升有据可依。
同标签 · 可观测 / 开源
Helicone AI
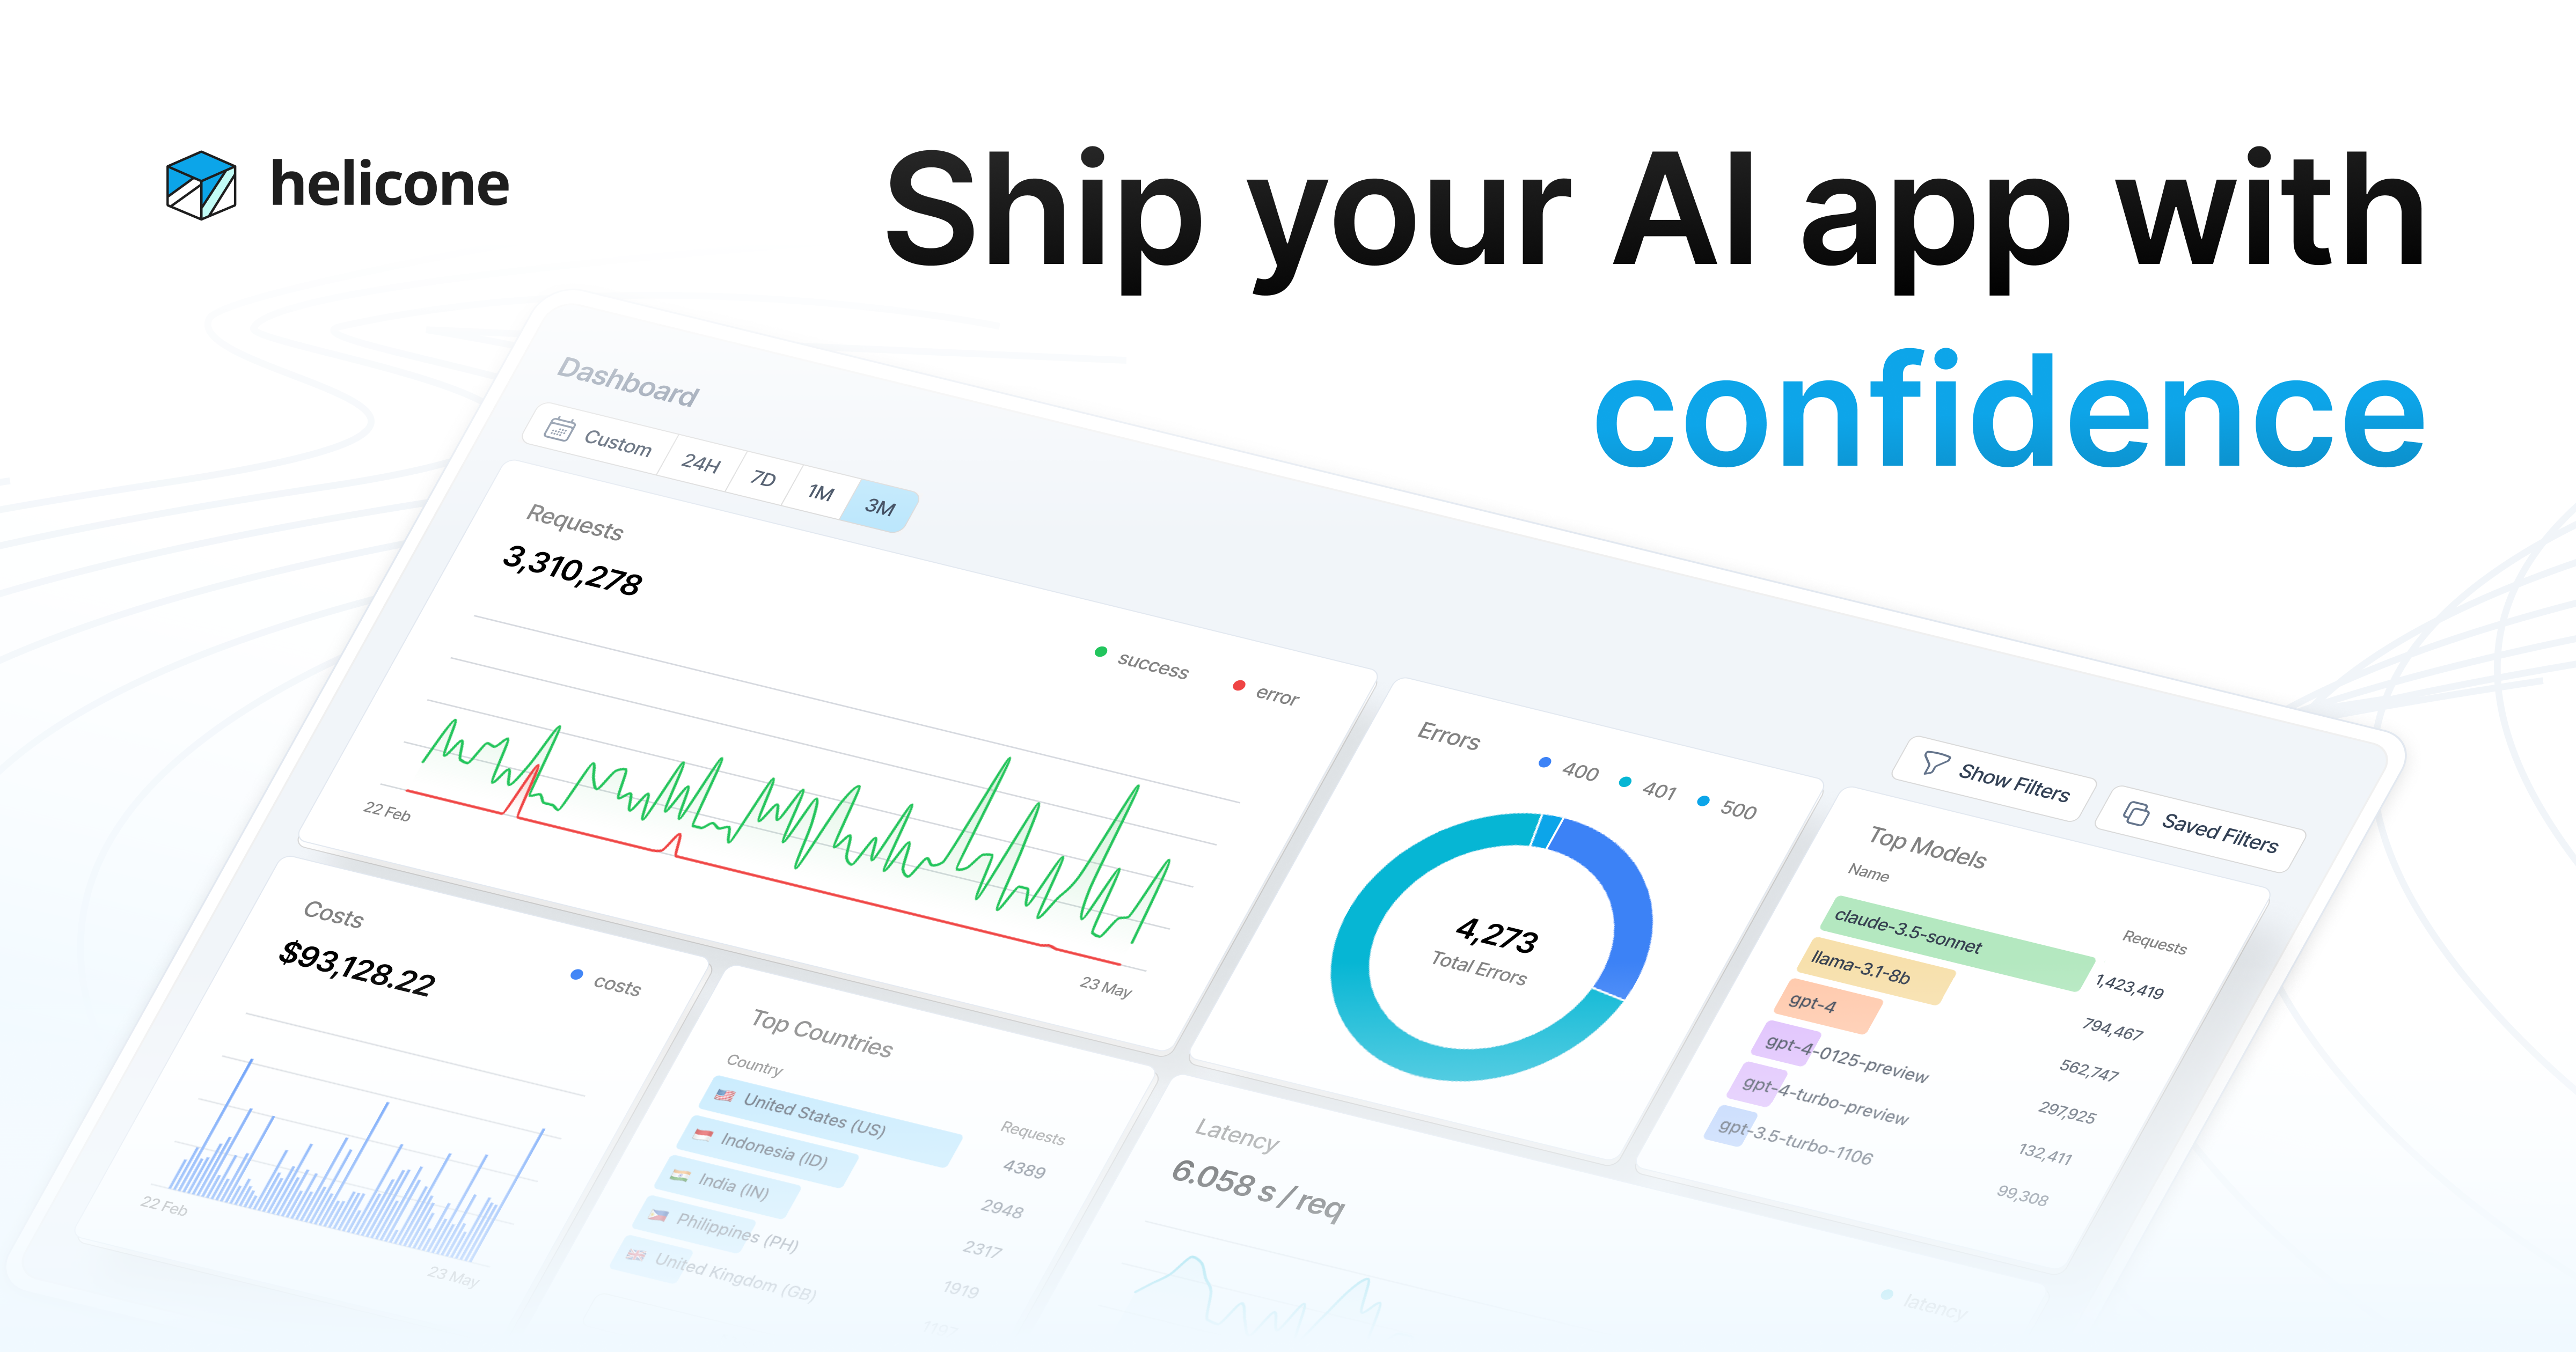
Helicone 是开源 LLM 可观测与 AI 网关平台:请求日志、监控告警、策略路由、多维细分与 HQL 分析,改一行 base_url 接入,被增长最快的 AI 公司使用。
同标签 · 可观测 / 开源

MLflow
MLflow 是最大的开源 AI 工程平台,覆盖 Agent、LLM 与传统模型:链路观测、系统评估、提示词优化、AI 网关与模型部署一站搞定,让 AI 迭代快十倍。
同标签 · 开源
Agentset
Agentset 是开源 RAG 与智能体构建平台,几分钟搭出生产级问答应用:多模态解析图片图表表格、自动引用来源、支持元数据过滤与自托管,基准测试表现领先。
同标签 · 开源
Continue
开源 AI 代码助手项目,主打接入任意模型自定义补全与对话;团队已被 Cursor 收购,开源代码库仍可自由获取,可自行部署与改造。
同标签 · 开源
Vanna.ai
开源 SQL 智能体框架,让不懂 SQL 的用户用自然语言查询公司各业务系统,内置用户级权限、配额管理、现成 UI 组件,支持多数据库与多轮对话。
同标签 · 开源