LlamaIndex
代码编程与辅助以文档智能为核心的 AI 数据框架,旗舰能力 LlamaParse 用智能体式 OCR 把带复杂表格、图表的文档解析成 AI 可用的结构化上下文。
详细介绍
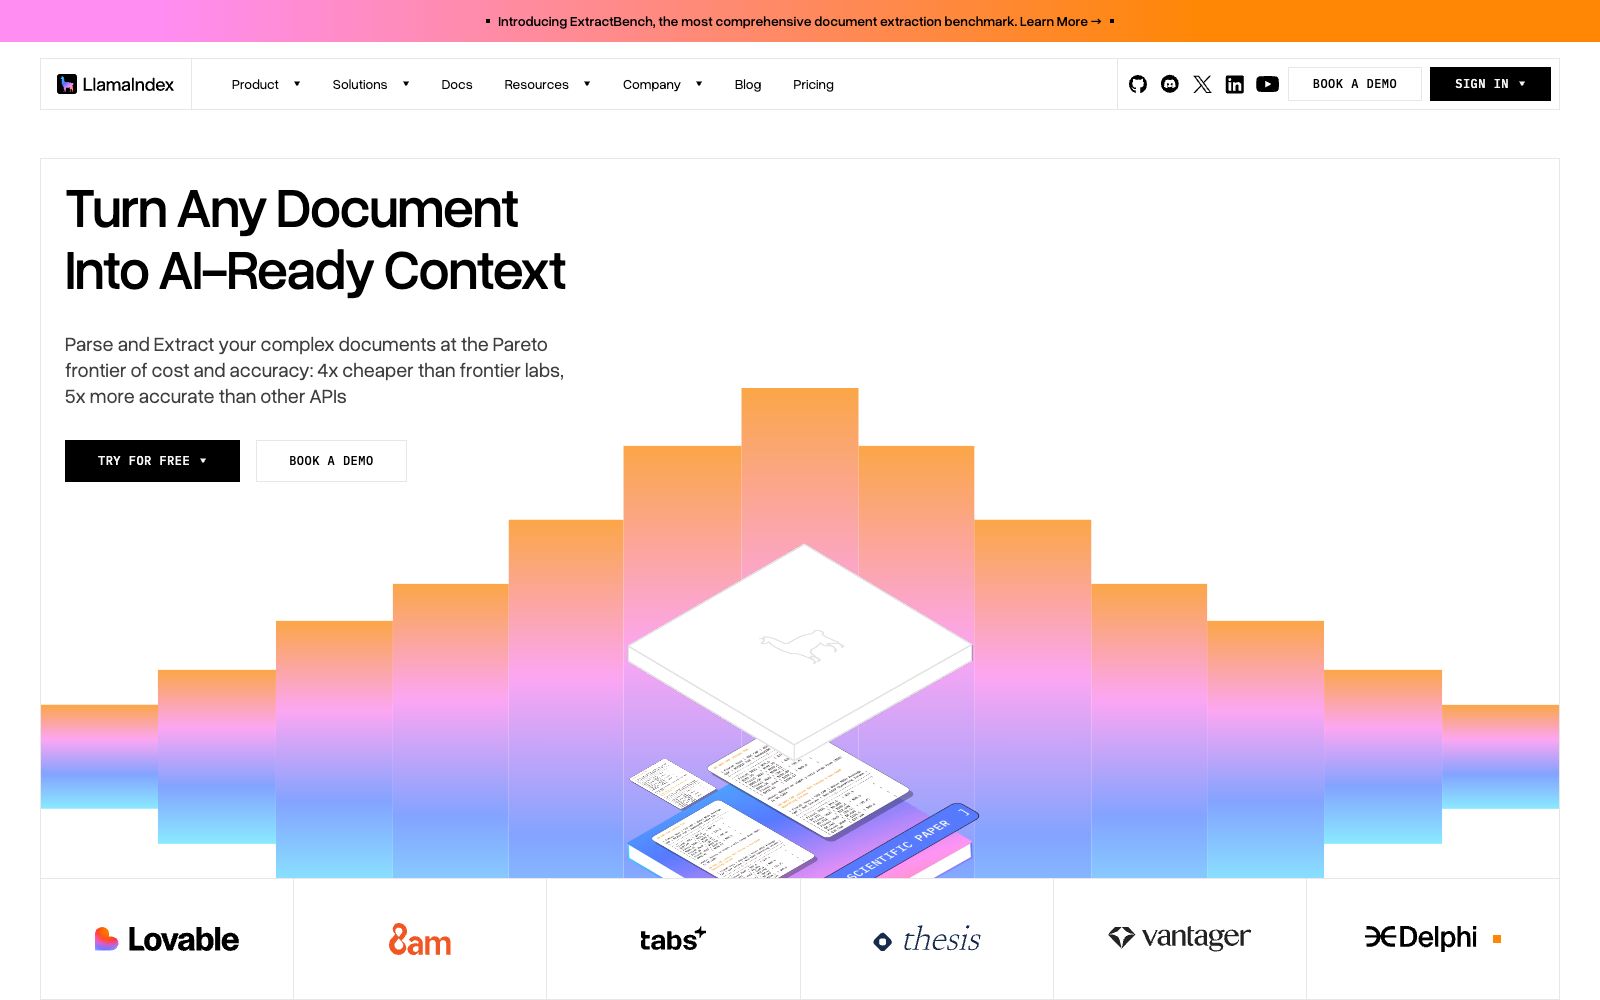
LlamaIndex 是一个以文档智能为核心的 AI 数据框架,目前官网主打的旗舰能力是 LlamaParse——官方称之为"全球最好的智能体 OCR",专门处理带复杂表格、图表与图片的文档,目标是接近人工的解析准确率。官方定位是"把任意文档变成 AI 就绪的上下文",并在此基础上提供从解析到索引、再到文档智能体的完整能力;框架本身完全开源,官网宣称被众多领先 AI 团队用于文档密集的行业场景。它同时提供从解析到索引的完整工具链,帮助团队把文档处理能力沉淀为内部基础设施。
核心能力
- 智能体 OCR:面向版面复杂的文档做布局感知解析,官方称准确率接近人工水平,覆盖杂乱表格、图表、图片等难题;官方强调"智能体式理解"(Agentic Understanding),而非简单的规则解析。
- 结构化抽取:按指定 schema 抽取字段,解析结果可直接进入下游流程,不必再人工整理。
- 文档处理全家桶:涵盖 Parse、Extract、Split、Classify、Index 等环节,从解析到切分、分类与索引一站完成,并可构建端到端的文档智能体。
- 本地快速处理:提供全开源的本地处理能力,兼顾隐私与速度,适合对数据边界有要求的场景。
- 格式覆盖广:支持所有主流文档格式,并可输出边界框(Bounding Box)定位信息,方便做版面还原与可视化。
- 成本与精度优势:官方称在成本与准确率的平衡点上,比前沿实验室方案便宜 4 倍、比其他 API 准确 5 倍。
适合谁
要把大量合同、财报、研究报告、论文喂给 AI 的团队,尤其是文档密集的金融、法律、保险与医疗行业;正在做 RAG 或文档智能体、需要高质量解析层的工程团队;以及对解析数据边界有要求的组织,可利用其本地处理能力;也适合需要批量把历史资料数字化的团队。
使用建议
免费档每月提供 1 万点额度(约 1000 页),可先用它验证自家文档的解析效果。表格与多栏排版是最容易出错的地方,选型时务必拿自己最"脏"的那批文档做测试,对比解析输出与人工标注。对比不同解析方案时,建议用同一批样本文档跑统一评估,避免口径不一致,再决定是否规模化使用。
注意事项
- 免费额度之外按用量计费,大规模处理前先评估成本是否符合预算。
- 解析质量与文档本身复杂度强相关,个别极复杂版面仍可能需要人工校对。
- 结构化抽取的效果依赖你定义的 schema 是否清晰完整,前期需要投入设计。
- 作为框架,落地仍需工程集成与维护,不只是调一个 API 那么简单;企业级使用需评估其企业版方案与自身合规要求。
所属专题
相似工具

TextIn
合合信息旗下的智能文档处理平台,可把PDF、Office与扫描件解析为结构化数据,提供表格公式识别、单据审核流转以及图像增强、去水印等能力,面向企业文档自动化。
同标签 · 文档解析 / OCR
Agentset
Agentset 是开源 RAG 与智能体构建平台,几分钟搭出生产级问答应用:多模态解析图片图表表格、自动引用来源、支持元数据过滤与自托管,基准测试表现领先。
同标签 · RAG
Haystack
deepset 维护的开源 AI 编排框架,用模块化组件搭建可上生产的智能体、检索增强与语义搜索系统,每一步都可检视、调试与替换。
同标签 · RAG
Mintlify
面向 AI 智能体的文档与知识平台,文档可自我更新、以结构化方式被智能体读取,已有两万多家公司用于开发者知识库与知识管理,让文档持续保持最新。
同分类

腾讯云智能体开发平台
腾讯云的企业级智能体开发平台,提供 LLM+RAG、Workflow 与 Multi-agent 开发引擎,支持构建、分发、管理与运营一体化。
同标签 · RAG
Docsumo
Docsumo 用文档 AI 智能体把邮件与文档工作流端到端自动化,覆盖抽取、分类、核验与回写,官方称字段准确率 99%。
内容相近