Wren AI
代码编程与辅助开源核心的生成式 BI 智能体,用语义层(MDL)把自然语言转成 SQL,商业版与开源版跑同一上下文引擎,支持云端、VPC 与气隙部署。
详细介绍
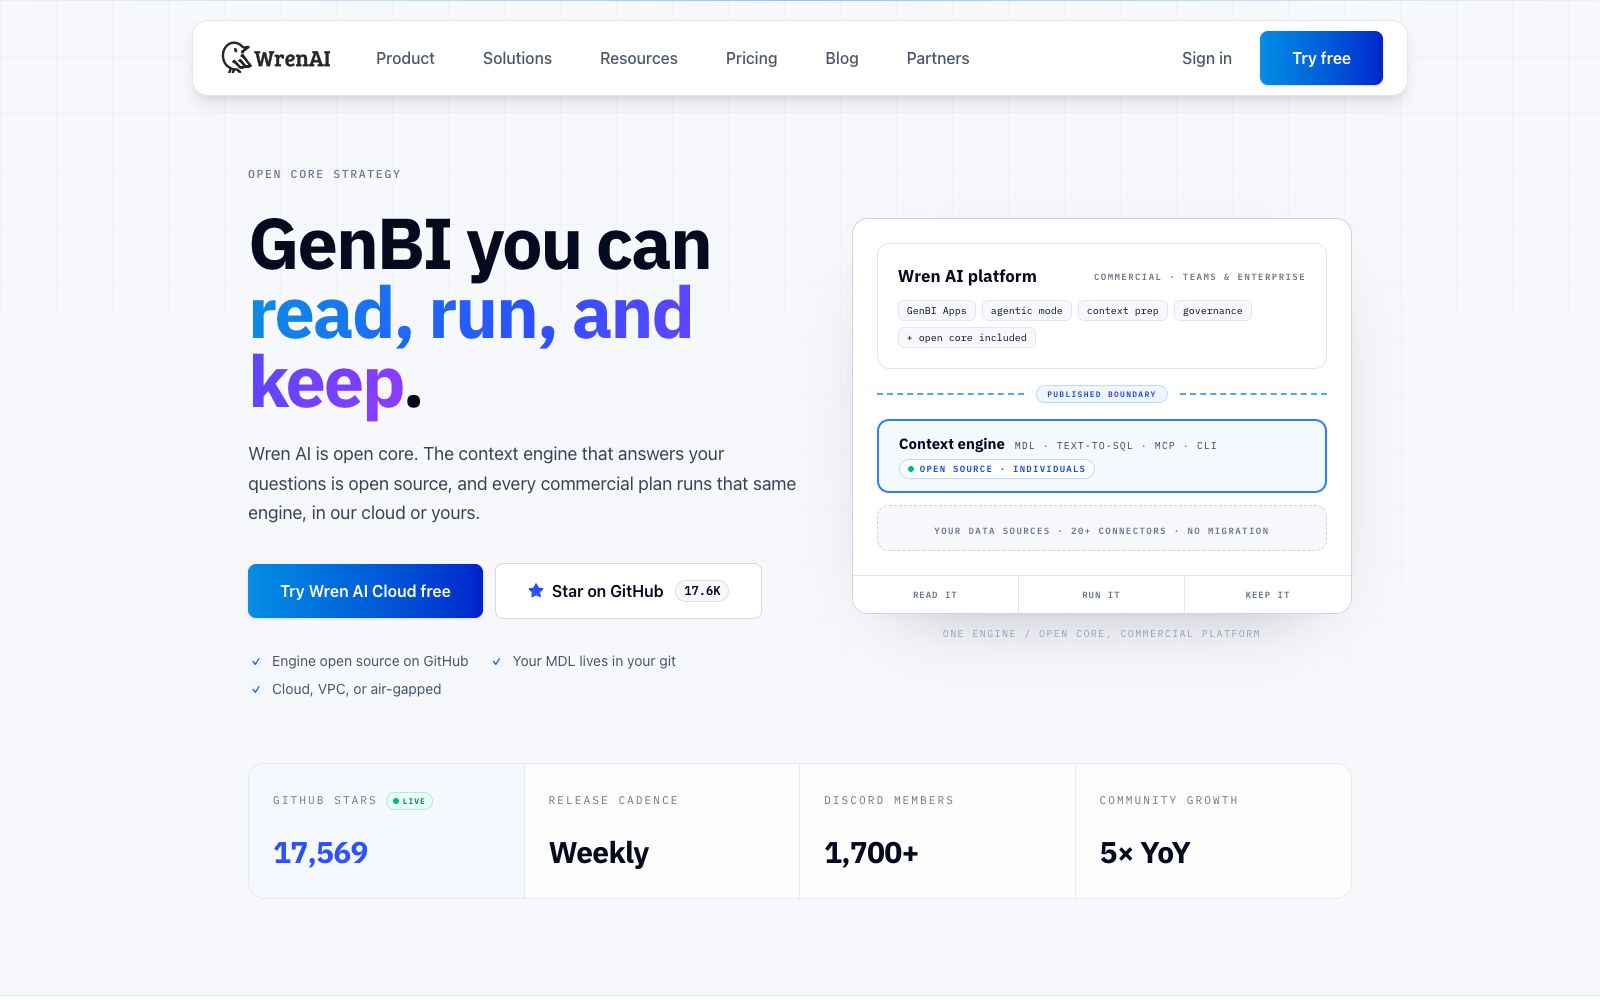
Wren AI 走 open core 路线:负责理解你问题的「上下文引擎」开源在 GitHub(约 17.6K stars),官方强调所有商业方案跑的都是同一个引擎——云上或自托管都一样,「没有黑箱,也没有锁定」(No black box, no lock-in)。它想解决的是「LLM 不懂你的数据」这件事(官方原话:LLMs don't know your data. The open core does.):靠一层语义模型(MDL)把业务名词映射到真实的表与字段,让自然语言查询落在准确的数据结构上。官方还提供覆盖 12 个平台、22 个选型要素的对比指南,供评估时参考。
核心能力
- Text-to-SQL 智能体:用自然语言提问,生成可执行的 SQL 并返回结果;核心的 TEXT-TO-SQL、MCP、CLI 均为开源组件。
- 语义层(MDL):业务术语与数据库结构的映射,是准确率的关键;MDL 直接存在于你的 Git 仓库中,可版本化、可审计、可协作,甚至可以先把语义模型离线搭好再接入引擎。
- 生成式 BI 应用:商业版在开源引擎之上叠加 Agent 模式、上下文准备(context prep)与治理(governance)能力,产品分为 Wren AI OSS、Wren AI Cloud 与 Enterprise Plus 三个形态,边界公开透明。
- 多部署形态:支持云端、VPC 内与气隙(air-gapped)环境,官方主张「从你的约束所在之处开始」(Start where your constraints are)。
- 可读可改:核心逻辑开源,团队可以阅读代码、本地运行;官方还专门列出「怀疑论者该问的问题」并公开开源/商业边界。
适合谁
希望让业务同事自助查数、又不想被商业 BI 平台锁定的数据团队;对数据不能出内网有硬性要求的企业(支持气隙部署);以及想先跑开源版验证、之后再平滑升级到付费方案的组织。
注意事项
- 准确率的天花板在语义层而非模型,MDL 定义不完整时,生成的 SQL 会频繁出错。
- 开源版是引擎,完整的 Agent 模式、上下文准备与治理能力在商业版,评估时注意开源与商业的边界。
- 语义层维护需要持续投入,业务术语变化后要及时更新映射;表结构复杂或命名混乱的库,前期整理 MDL 的工作量不可低估。
- 自托管需要自己准备模型、算力与运维资源;云版试用与付费条款以官网最新说明为准,开源版则完全免费、无使用限制。
- 生成 SQL 涉及写操作时,务必确认只读策略与权限配置,防止误改数据。
使用建议
先把核心指标与高频实体的定义在 MDL 里理清,再开放给业务方提问,语义层质量直接决定体验,值得优先投入;选型前对照官方「怀疑论者该问的问题」逐条确认(如停止付费后怎么办、能否从开源迁移到付费);小范围试点验证准确率后再推广到全组织。对结果准确性敏感的场景,可先用只读账号试点并人工核验一周,再逐步放开;数据团队规模不大、但想用低门槛方式开放数据能力的小型组织同样适用。
相似工具
Vanna.ai
开源 SQL 智能体框架,让不懂 SQL 的用户用自然语言查询公司各业务系统,内置用户级权限、配额管理、现成 UI 组件,支持多数据库与多轮对话。
同标签 · 开源
Continue
开源 AI 代码助手项目,主打接入任意模型自定义补全与对话;团队已被 Cursor 收购,开源代码库仍可自由获取,可自行部署与改造。
同标签 · 开源
Haystack
deepset 维护的开源 AI 编排框架,用模块化组件搭建可上生产的智能体、检索增强与语义搜索系统,每一步都可检视、调试与替换。
同标签 · 开源
Langfuse
开源(MIT)的 LLM 工程平台,把追踪、评估、提示词管理与数据集整合一处,基于 OpenTelemetry,用生产数据持续改进 AI 应用,可自托管。
同标签 · 开源
Agentset
Agentset 是开源 RAG 与智能体构建平台,几分钟搭出生产级问答应用:多模态解析图片图表表格、自动引用来源、支持元数据过滤与自托管,基准测试表现领先。
同标签 · 开源
Kilo
开源 AI 编码代理,覆盖 VS Code、JetBrains、CLI 与云端,可接入 500 多个模型并支持自带密钥零加价,用本地模型可保护代码隐私。
同标签 · 开源