Nebius
其他面向 AI 团队的专用云平台,官网称从硬件到接口全栈自建,提供非虚拟化显卡、高速互联与托管推理,覆盖从实验到大规模训练与推理的场景。
详细介绍
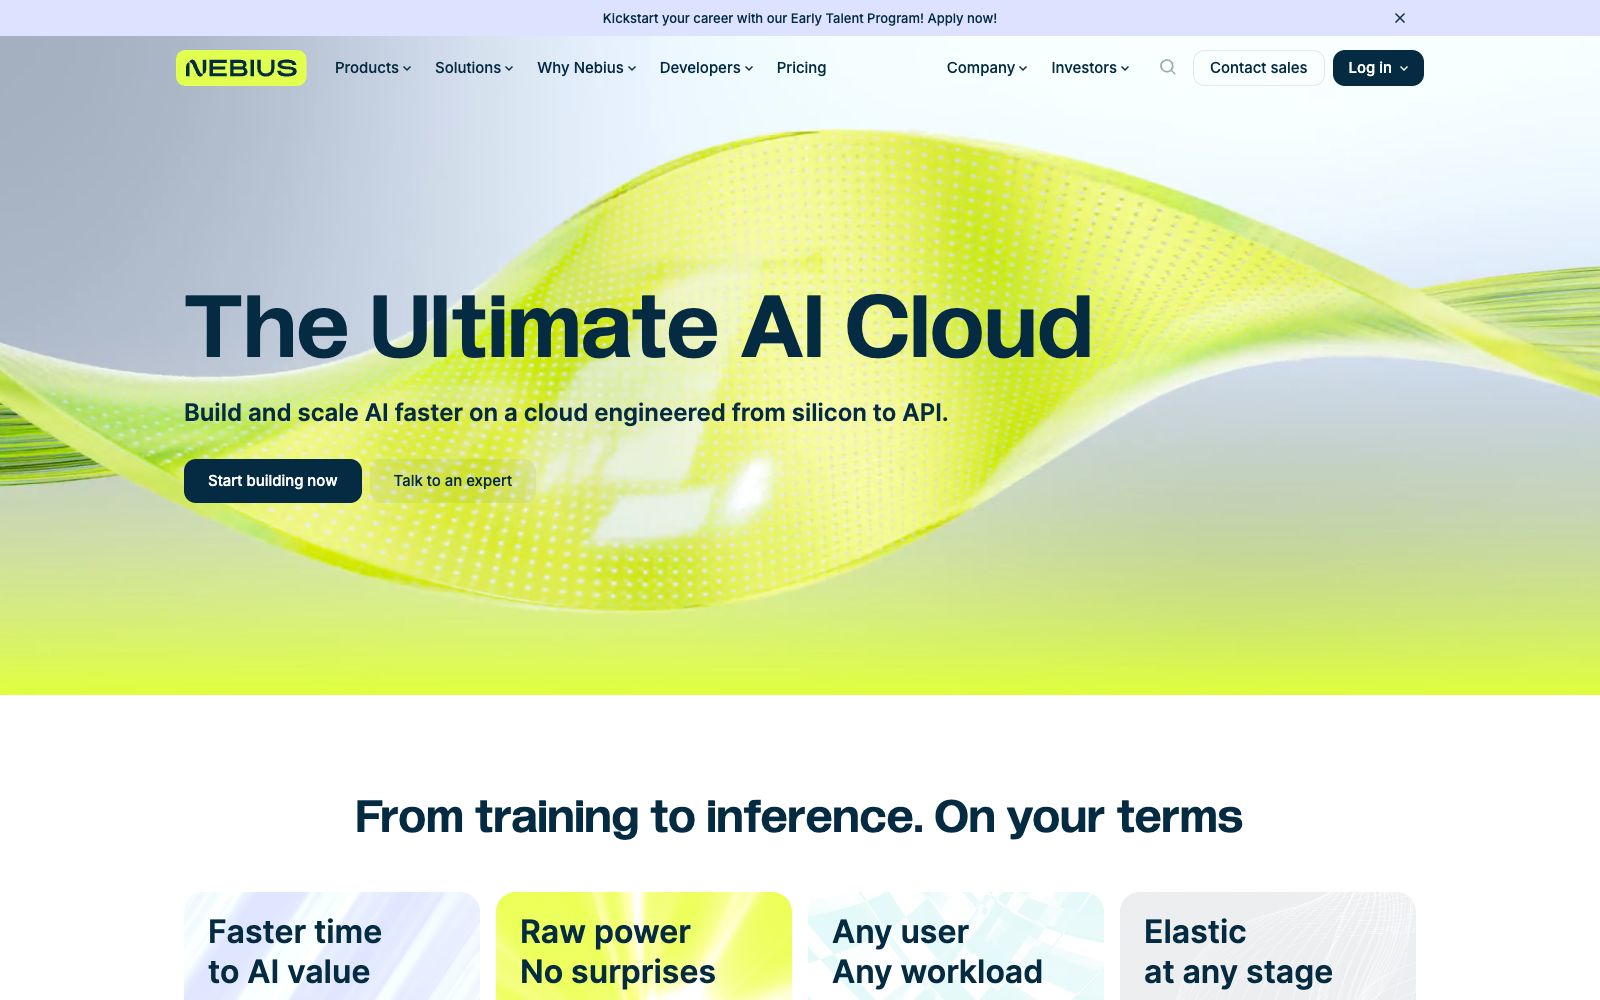
Nebius 是面向 AI 工作负载的云平台,官网自我定位为终极 AI 云,强调从底层硬件到上层接口都为 AI 场景专门设计。与其在通用云上拼装显卡实例不同,它主打非虚拟化 GPU、高速互联和配套的工程工具,官网称客户可在几分钟内从零扩到集群规模。页面把能力分成更快见效、稳定算力、适配任意负载与弹性伸缩四条来讲,并列出多家客户案例与全天候支持。
核心能力
- Faster time to AI value:官方称可在几分钟内从零扩展到集群,并支持可复现的自助开通。
- Raw power. No surprises:官网描述为采用非虚拟化 GPU 与 InfiniBand 的定制硬件,并称具备行业领先的可靠性指标。
- MLOps tooling 与 managed inference:官方称平台内置机器学习运维工具,并提供无服务器与托管推理。
- Elastic at any stage:官网称从小型实验到全球规模环境都有灵活的消费方式。
- Training to inference:官方定位覆盖训练与推理两端,按用户自己的节奏使用。
- Expert support:官网称提供数百名 AI 专家支持、默认全天候响应与免费的概念验证协助。
- Security by design:官网列为平台设计原则之一。
适合谁
- 要做大规模分布式训练、需要高速互联的算法团队
- 从通用云迁移出来、想降低单卡小时成本的初创公司
- 需要托管推理、又不想自建运维的中小 AI 产品团队
- 对硬件直通和性能一致性有要求的科研计算项目
使用建议
- 先把一个小规模训练跑完,验证互联带宽与存储读写是否达到预期,再决定集群规模
- 官方支持免费概念验证,复杂迁移前先申请一轮,比自己踩坑划算
- 定价与消费方式较灵活,长跑任务建议提前锁定资源与预算上限
- 跨云迁移要预留数据搬运时间,大模型权重进出是隐性成本大头
- 区域可用性会调整,生产部署前确认目标区域是否有你需要的卡型
相似工具
Lambda
面向 AI 训练的云算力服务商,官网称提供多种高端显卡的按需实例与集群预留,配套编排工具与工程支持,覆盖从初创团队到政府与企业的场景。
同标签 · GPU集群 / 模型训练
Lightning AI
PyTorch Lightning 原班团队打造的 AI 云平台,官网提供按需显卡、集群与编码智能体,覆盖数据集构建到训练与推理全流程,面向自研专用模型的团队。
同标签 · AI云 / 模型训练
Paperspace
DigitalOcean 旗下的云 GPU 平台,提供 H100 等显卡算力与主机,覆盖模型开发、训练到部署的完整流程,也提供云桌面与渲染工作流。
同标签 · 模型训练
Vertex AI
谷歌云旗下的 AI 开发平台,官网现以 Gemini platform 命名,提供模型调用、训练调优与智能体部署能力,面向要把 AI 接入生产系统的技术团队。
同标签 · 模型训练
AutoDL算力云
国内 GPU 算力租用平台,运营方为视拓云(南京)科技,提供秒级计费的 GPU 租用、高规格机房与 7x24 小时服务,并内置 AI 镜像与技术社区,开箱即用可一键复现算法。
同标签 · 模型训练
Together AI
Together AI 是 AI 原生云平台,提供开源模型推理、微调与 GPU 集群,OpenAI 兼容接口迁移方便,官方称推理快 2 倍、成本低 60%、预训练快 90%。
内容相近