GPUStack
其他企业级 AI 基础设施平台,官方称可在任意硬件上部署、治理和扩展大模型与 GPU 算力,支持异构显卡、自动匹配推理引擎、分布式推理,并提供标准接口与配额管理。
详细介绍
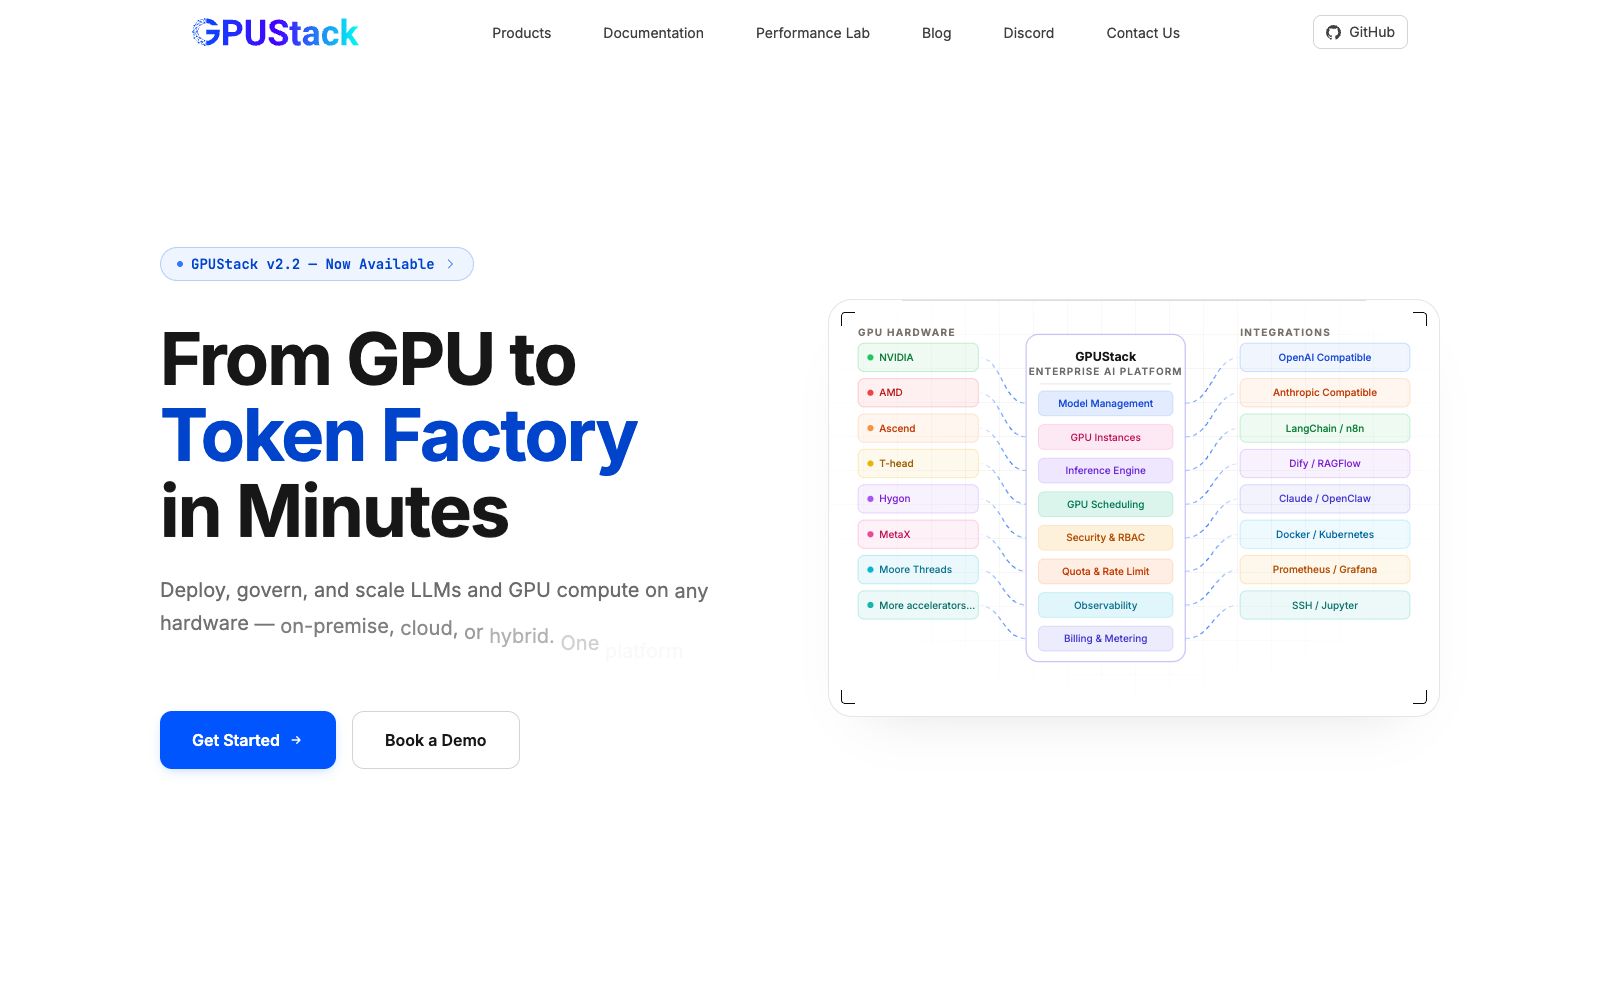
GPUStack 是企业级 AI 基础设施平台,官网标题为「企业级 AI 基础设施平台」,主张在任何硬件上部署、治理和扩展大模型与 GPU 算力,把模型服务和算力服务放在同一个平台上。它面向的是自建或混合部署的团队,覆盖从连接模型源、自动选引擎到扩容、计费和可观测的完整链路,官网列出的部署形态包括本地机房、Kubernetes 与多云。
核心能力
- 任意显卡统一纳管:官网列出 NVIDIA、AMD、昇腾、平头哥、海光、沐曦、摩尔线程等多家加速器,做统一纳管与调度。
- 连接模型源:可从 Hugging Face、ModelScope 拉取模型,也支持本地模型文件,官方称会自动做兼容性检查。
- 自动匹配推理引擎:官方称会按硬件自动映射到最合适的推理引擎版本,无需手工配置,覆盖主流推理框架。
- 分布式推理扩展:支持跨机分布式推理,把大模型拆到多张卡上跑,突破单机显存限制。
- 标准接口服务:提供兼容主流生态的 API,官方列出可与常见编排、检索和监控工具直接集成。
- 企业级治理:平台包含模型管理、GPU 实例、调度、安全与角色权限、配额与限流、可观测性以及计费计量。
适合谁
- 手里有一批异构显卡、需要统一调度的高校与科研机构。
- 要在本地机房或私有云里自建模型服务的企业 IT 与平台团队。
- 跨多云和 Kubernetes 混合部署、需要统一运维口径的工程团队。
- 需要给内部业务线做算力配额、计费和权限隔离的平台负责人。
- 想把模型服务封装成内部能力、对外提供统一接口的部门。
使用建议
- 先按官网的四步流程跑通单卡部署,再做分布式扩展,能更快定位是模型还是调度的问题。
- 上生产前确认目标显卡型号在官方支持列表里,异构环境尤其要查驱动与引擎版本。
- 用配额与限流把不同业务线隔开,避免一条链路把整池算力吃满。
- 关注官方的性能模式与安全合规说明,涉及生产数据时先做一次权限审计。
- 官网版本号与集成能力会持续更新,落地方案以当前官方文档为准。
相似工具
RunPod
面向开发者的 AI 云平台,提供按需 GPU、无服务器端点、多节点集群与模型部署四类形态,覆盖推理、Agent、微调与计算密集任务,并公开各型号 GPU 的单价。
同标签 · 模型部署 / 算力平台
BentoML
BentoML 是面向生产环境的模型推理平台,支持任意模型部署、定制推理优化与弹性伸缩,并开源模型服务框架,主打速度与可控性。
同标签 · 模型部署
Paperspace
DigitalOcean 旗下的云 GPU 平台,提供 H100 等显卡算力与主机,覆盖模型开发、训练到部署的完整流程,也提供云桌面与渲染工作流。
同标签 · 算力平台

无问芯穹
通用人工智能基础设施服务商,官方称以 M 种模型乘 N 种芯片的技术范式做多元异构算力调度,提供 Agentic Infra 平台与 Agentic MaaS 大模型服务。
同分类
算家云
算家云是高性能 GPU 算力租赁与 AI 训练推理平台,提供 A100、4090、5090 等显卡按需租用,上百种开源模型一键启动,官网称 4090 低至 1.24 元/卡时。
同标签 · 模型部署
AutoDL算力云
国内 GPU 算力租用平台,运营方为视拓云(南京)科技,提供秒级计费的 GPU 租用、高规格机房与 7x24 小时服务,并内置 AI 镜像与技术社区,开箱即用可一键复现算法。
同标签 · 算力平台