Artificial Analysis
研究与数据分析独立评测 AI 模型与 API 服务商的基准站,围绕智能指数、输出速度与单任务成本横向对比,覆盖编码、语音、图像、视频等多门类榜单与搜索服务商对比。
详细介绍
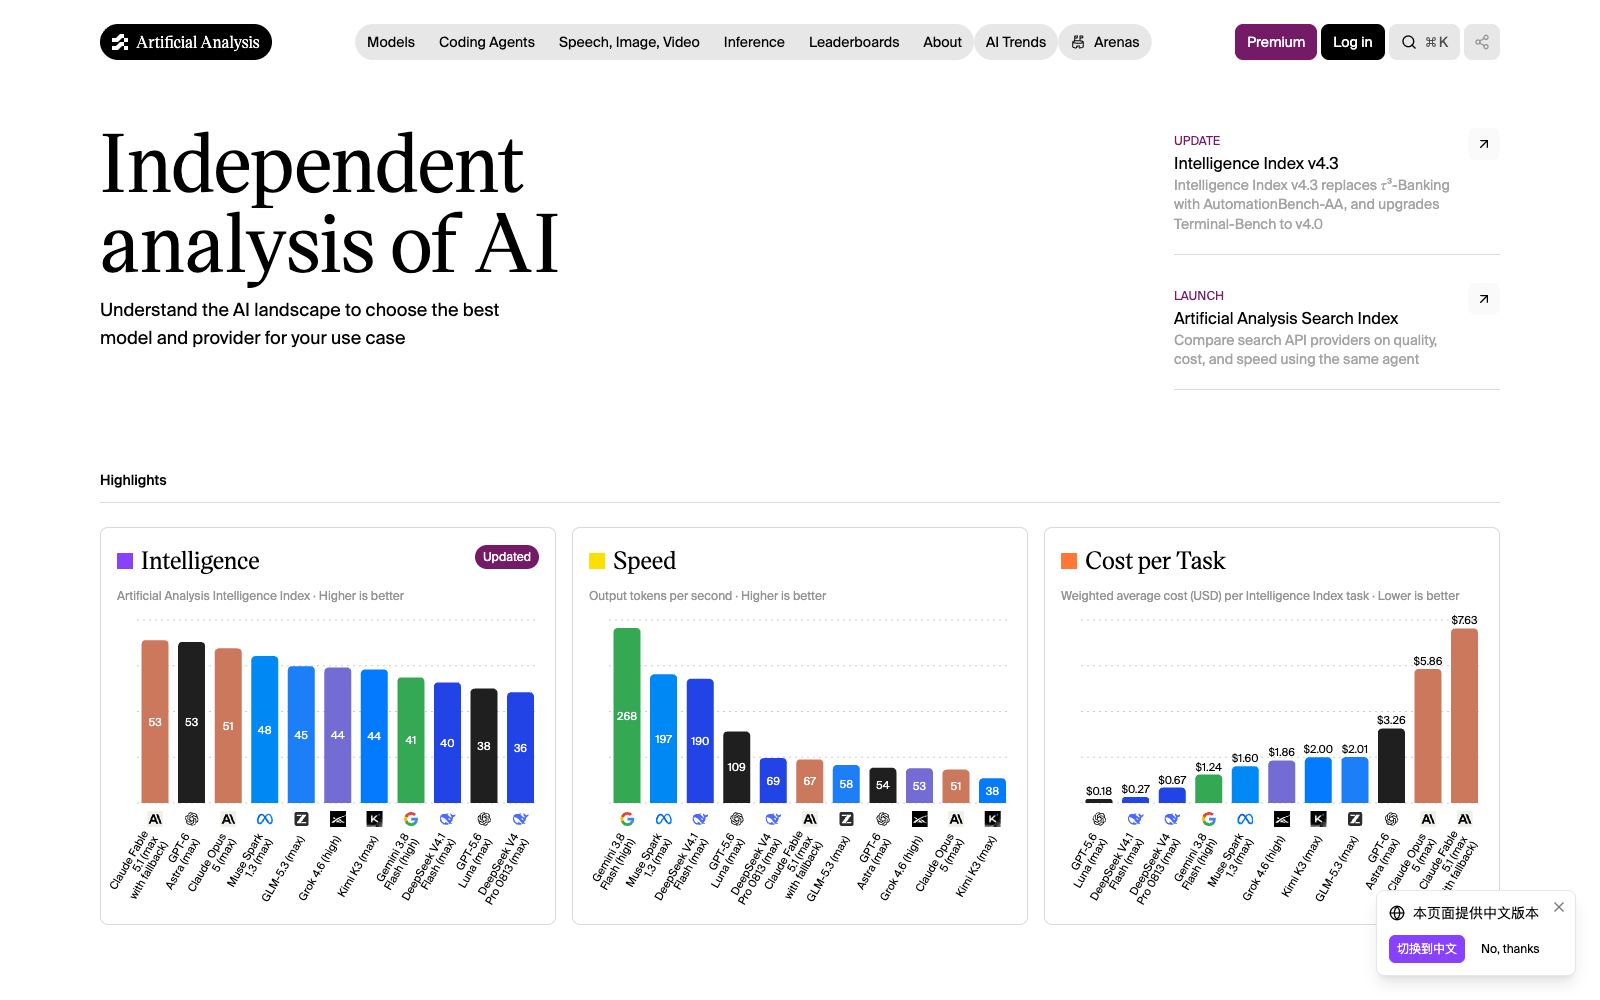
Artificial Analysis 是一个独立评测 AI 模型与 API 服务商的基准网站,帮助使用者理解当前 AI 格局,为自己的场景挑选最合适的模型与供应商。它不依赖厂商自报数据,而是围绕质量、价格、输出速度与延迟等关键指标独立跑分,并同时覆盖模型本身和提供 API 托管的服务商。官网以「Independent analysis of AI」为口号,数据持续更新,是模型选型时常用的第三方参考,也常被评测与媒体引用。
核心能力
- 智能指数(Intelligence Index):自建的综合智能评分体系,给模型能力打分并持续更新;官网公开指数版本变更说明(例如最新版本用新基准替换旧任务、升级终端操作类评测),保证分数反映前沿能力,也方便追溯。
- 成本对比:提供「每完成一次智能指数任务的成本」等指标,把模型性能换算成可比的钱,让「质量 vs 预算」的权衡有量化依据。
- 速度与延迟:展示输出速度等性能指标,配合价格一起横向比较,避免「只比质量、不比成本与速度」的片面选型。
- 模型与服务商双线对比:同一模型在不同托管服务上的表现差异也能比,支持按 Open Weights(开放权重)与 Proprietary(闭源)分类浏览,方便挑选 API 供应商。
- 分门类榜单:除语言模型外,覆盖编码智能体、语音、图像、视频、推理等多个门类的榜单,满足不同应用场景的选型需求。
- 搜索索引(Search Index):新推出的搜索类 API 服务商对比,用同一套智能体评测质量、成本与速度,覆盖检索增强与智能搜索类应用场景。
适合谁
需要做模型选型的工程师与产品决策者;需要在成本与质量间权衡的创业团队与个体开发者;写评测、报告或文章需要引用第三方基准数据的分析师与媒体;以及想持续跟踪模型能力演进、关注每次指数版本变化的研究者。
注意事项
- 指数与榜单会随版本更新而变动,引用数据时务必标注版本与抓取时间,避免引用过时结论。
- 榜单是「通用能力」的近似,不代表你的具体任务表现;编程、写作、长上下文等细分场景建议再看对应门类的专门榜单。
- 价格与速度数据通常基于官方定价与公开测试,实际调用成本可能因用量、区域与缓存策略而不同,最终以服务商账单为准。
- 网站以英文为主,数据展示维度较多,初次使用建议先锁定自己关心的指标(质量 / 成本 / 速度),再逐步展开对比。
使用建议
榜单适合缩小候选范围:先按自己的场景锁定门类,再在质量与「单任务成本」之间找平衡点。最终决定前,用你自己的真实任务对入围的 2-3 个模型做一轮小规模对比测试,比任何榜单都更可靠;做技术选型汇报时,注明数据来源版本与时间,能让结论更站得住脚。
相似工具
LLM Stats
把 300 多个 AI 模型的智能水平、速度与价格折算成单一综合分的独立榜单,数据持续从公开基准与真实 API 指标更新,支持多任务维度排行。
同标签 · 基准 / 模型对比
SEAL LLM Leaderboard
Scale AI 旗下 Labs 出品的专家驱动评测榜单,覆盖智能体编程、前沿推理与安全对齐等 20 多个基准、100 多个模型,可按能力维度分档浏览并持续更新。
同标签 · 评测
imgsys
fal.ai 推出的生成图像模型竞技场,用同一提示词对比不同模型出图,按用户投票给出人气排名并标注样本量,覆盖商业与社区模型,可直接在线试玩。
同标签 · 评测

SuperBench
清华大学基础模型研究中心联合中关村实验室发布的大模型综合能力评测榜单,以双月报告推动公平、公开、系统的大模型评测与技术进步。
同分类
ChatHub
一个把多个聊天机器人并排放在一起的比较工具,同一个问题同时发给多家模型,支持图像生成、文件分析与网页搜索,覆盖网页、移动端与桌面端。
同标签 · 模型对比
清博智能
清博智能是人工智能与大数据科技企业,业务覆盖大模型与智能体、智库报告、指数榜单、数字人与视频营销,服务品牌、政务与媒体传播场景。
内容相近