
Veo 3
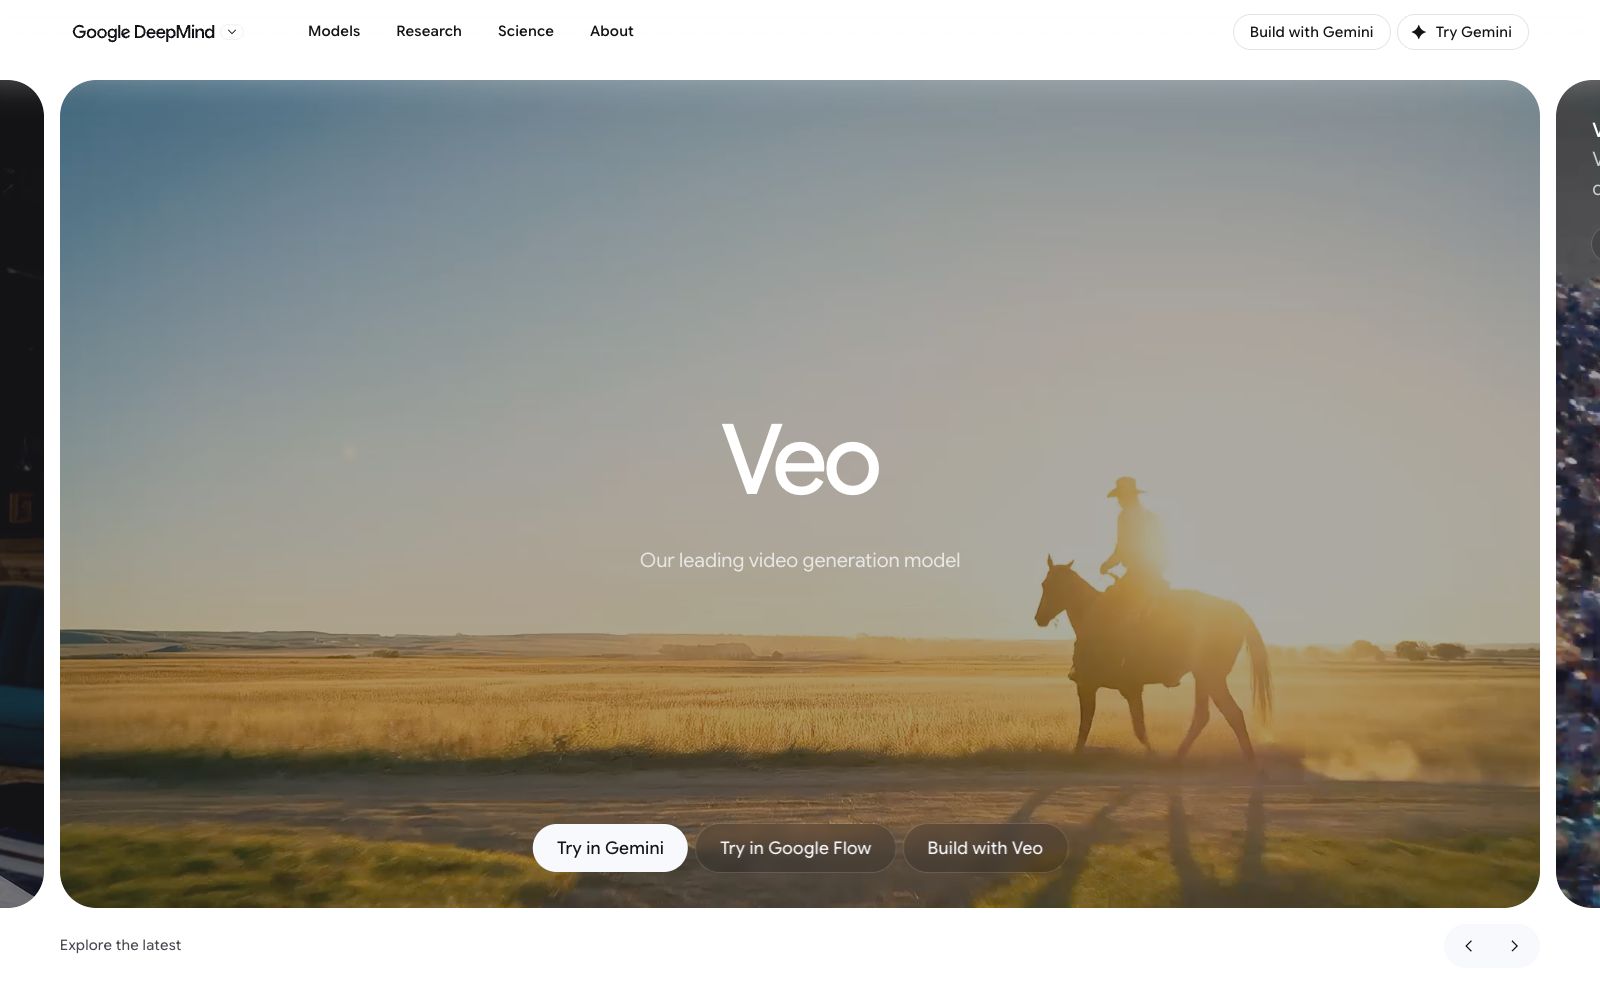
视频与动画Veo 是 Google DeepMind 的视频生成模型,官网介绍其新版本在真实感、指令遵循与创作控制上的提升,并新增原生音频生成,可叠加参考图、风格图与镜头控制。
详细介绍
Veo 是 Google DeepMind 的视频生成模型,官网把它的定位写成「生成带音频的电影感视频」。目前官网主推的版本是 Veo 3.1,而 Veo 3 的关键变化被官方单独强调为两点:一是引入了原生音频生成,二是扩展了创作控制。官网给出的示例提示词里,同一段描述里同时写了画面(medium shot、镜头缓推、背景墙绘)和声音(城市人声、灵魂乐节拍、人物台词),这正是它与「画面生成完再配音」那类工具的差别所在。
核心能力
- 原生音频生成:官方写明可以为作品加入音效、环境音与对白,音频一并生成。
- Add ingredients to your video:给模型提供场景、角色或物体的参考图,用来约束生成结果。
- Match your style:提供风格参考图,生成同一视觉风格的视频,从绘画风格到电影感画面都支持。
- Keep your characters consistent:给角色参考图,让同一角色在不同场景中保持外观一致。
- Extend your scene:用第一个镜头的最后一秒继续往下演,官网强调在延长的同时保持画面与音频一致。
- Camera controls 与 First and last frame:分别用于精确控制镜头运动与构图,以及用首尾帧做出平滑过渡。
适合谁
- 做广告片与概念短片的创作者:需要画面与声音同时成立的场景。
- 需要角色跨镜一致性的叙事项目:官网把「保持角色一致」作为独立功能列出。
- 分镜与运镜需要精确控制的团队:镜头控制与首尾帧都是为这类需求准备的。
使用建议
- 它是模型而非成品工具,官网引导你去对应的生成入口体验(页面上有 Try in Flow 之类的入口),先确认手上有没有可用渠道再规划产能。
- 带原生音频意味着声音也是生成结果,若需要精确的台词或品牌口播,后期一定要再做一次对齐与混音。
- 官网设有 Safety 与 Capabilities 等板块,合规要求请直接读官网相关章节,不要凭印象推断可用范围。
- 参考图决定生成走向,务必用授权素材;模型版本迭代很快,能力清单以官网当前页面为准。
相似工具
SkyReels
SkyReels是昆仑万维推出的AI视频生成平台,围绕故事化叙事提供文生视频、图生视频与多模态参考生视频能力,官方称可同时生成画面与声音,并支持跨分镜的角色一致性与情节延续。
同分类
Hedra
Hedra 官方定位为视觉推理模型与基础设施研发机构,同时面向创作者提供可视化工作台,可在同一画布上跨视频、图像、音频模型进行规划、生成与剪辑。
同标签 · 视频生成

Digen AI
Digen AI 是一家以智能体技能为核心的 AI 视频生成平台,提供从剧本到成片的短片技能、MV 与舞蹈视频生成,站内集成多家视频模型并配套音频与放大工具。
同标签 · 视频生成

Oiiyao
Oiiyao 千影万音是一站式 AI 视频创作与本地化平台,官方称提供 70+ 语种视频翻译、配音与口型同步,并支持文生视频、首尾帧与全能参考式的视频编辑转绘、智能擦除和视频换脸。
同标签 · 视频生成
LibTV
LibTV是LiblibAI旗下的专业视频创作工具,内置MiniMax、Wan与Seedance等模型,支持视频、图片、音频、剧本生成与智能剪辑。
同标签 · 视频生成

小云雀AI
字节跳动(抖音)旗下 AI 内容创作 Agent,覆盖短剧、营销视频与通用创作,内置 Seedance、Seedream、Seed Audio 模型,网页版与 App 可用。
同标签 · 视频生成