RunPod
其他面向开发者的 AI 云平台,提供按需 GPU、无服务器端点、多节点集群与模型部署四类形态,覆盖推理、Agent、微调与计算密集任务,并公开各型号 GPU 的单价。
详细介绍
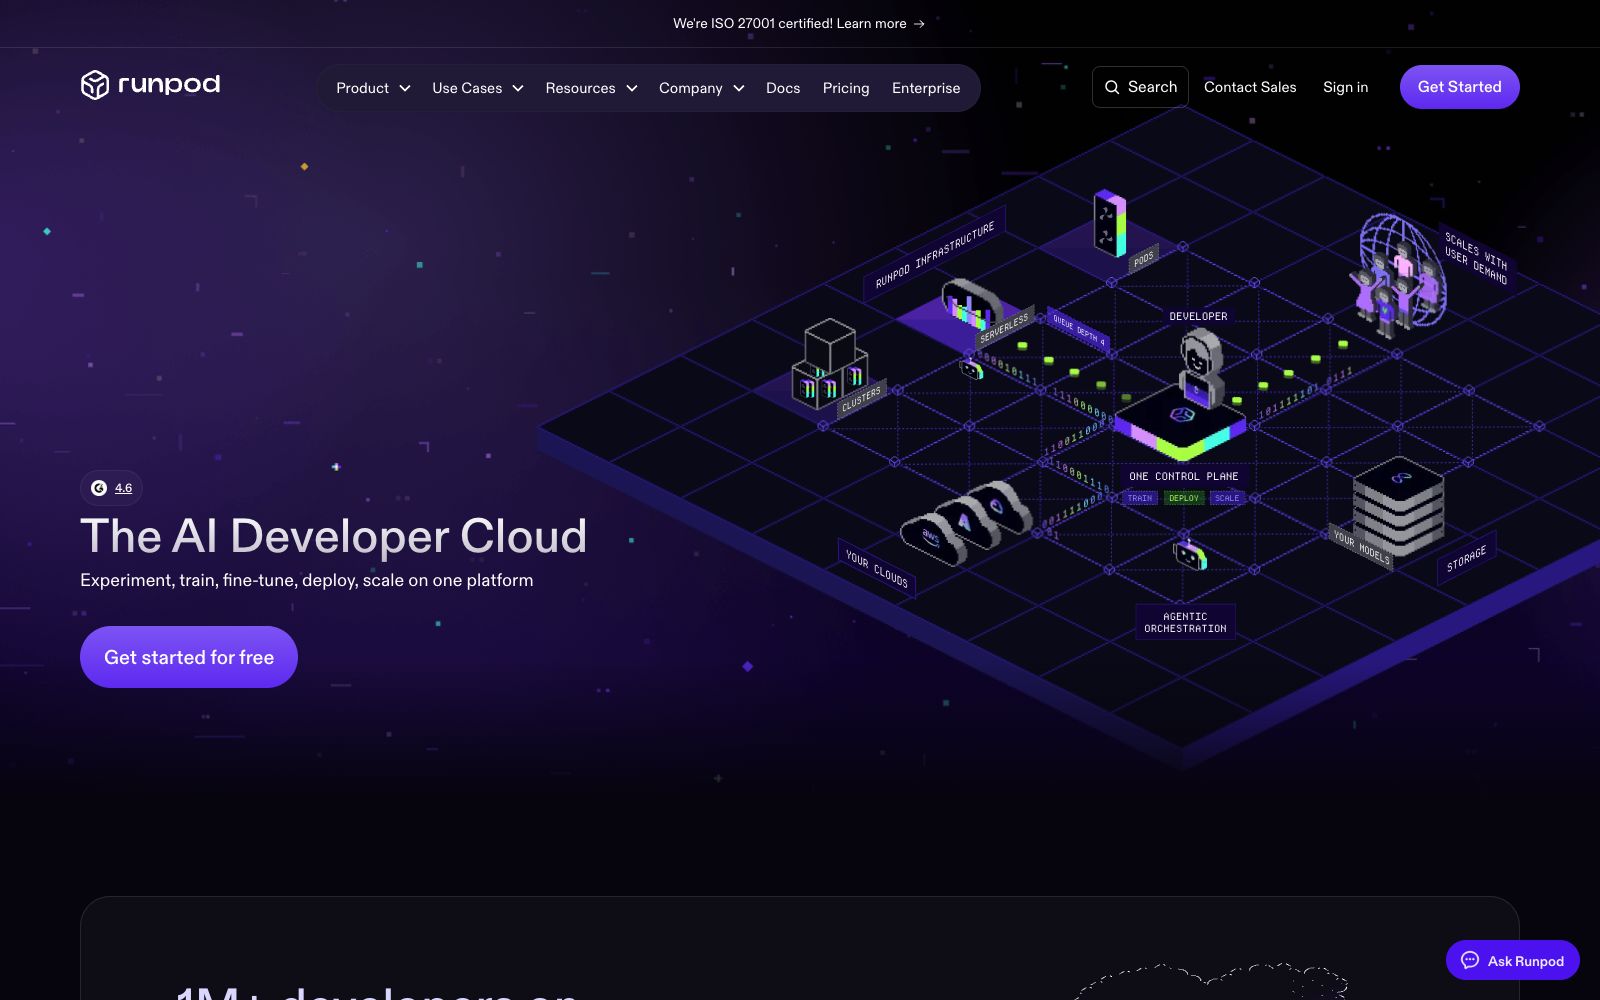
RunPod 的自我定位是「The AI Developer Cloud」,首页大标题写着「Experiment, train, fine-tune, deploy, scale on one platform」。它把云算力拆成四块产品:Pods 是按需 GPU,官网标注分布在 31 个全球区域;Serverless 用 API 跑 AI 工作负载;Clusters 跑多节点分布式任务;Hub 直接部署开源模型与模板。官网首页还把这个平台描述成「1M+ developers on Runpod」,并列出 Inference、Agents、Fine-Tuning、Compute-Heavy Tasks 四类用例。
核心能力
- Pods(按需 GPU):独立实例按需拉起,官网定价页公开了各型号单价,例如 B300 为 8.99 美元/小时、H200 5.29、H100 SXM 3.99、A100 SXM 1.79、RTX 5090 1.19、A40 与 A6000 均为 0.59 美元/小时。
- Serverless:官网称按 API 计费的 GPU 端点,冷启动无预热税,适合流量不定的推理服务。
- Global Volumes(Beta):官网公告显示可把全局卷挂到 Serverless 端点上,worker 在任意数据中心启动,模型权重只存一份随处可读。
- Clusters:多节点 GPU 集群,用于分布式训练等大规模作业。
- Hub:官网提供开源模型与模板的部署入口,另有统一控制台管理自有与平台算力的 Deployments 与 Models。
- 企业级可用性:官网列出托管编排、实时日志与企业级可用性。
- 官方报告与教程:站内提供 State of AI Compute 等数据报告,以及把 27B 决策模型部署到 Serverless 端点的教程。
适合谁
- 要把模型部署成对外 API、且流量时高时低的算法与工程团队,Serverless 尤其合适。
- 需要多区域就近访问、把数据放在特定地区以满足合规要求的团队。
- 做微调与分布式训练、需要多节点互联的研究团队。
使用建议
- 选实例按显存倒推,别只看单价;官网定价页把 Community Cloud 与 Secure Cloud、按时与按秒两种口径分开列,先确认落在哪一档。
- Serverless 的按量计费适合不稳定流量,但要设好并发与超时上限,否则突发请求会直接把账单拉高。
- 上传的数据与模型权重在多区域间的分布规则,是合规评估里最容易被忽略的一环,务必查官方文档确认。
- 用 Global Volumes 时确认挂载与读写权限设置,避免出现跨区读取异常。
- 官网标注价格与新特性(如 Global Volumes 处于 Beta)都可能变动,扩容前再核一次价格页。
相似工具
AutoDL算力云
国内 GPU 算力租用平台,运营方为视拓云(南京)科技,提供秒级计费的 GPU 租用、高规格机房与 7x24 小时服务,并内置 AI 镜像与技术社区,开箱即用可一键复现算法。
同标签 · 算力平台 / GPU租用
fal.ai
面向开发者的生成式媒体推理平台,提供一千多个图像、视频、音频与3D 模型的统一 API,并支持按需 serverless GPU 与独占集群部署自建模型。
内容相近

派欧云
分布式云计算服务商,官方称提供大模型与图像视频模型 API、Agent 沙箱与托管、GPU 容器实例与 Spot 算力,兼容 OpenAI 与 Anthropic 接口标准。
同分类
Replicate
运行与部署开源 AI 模型的云平台,官方称社区已发布数千个可直接调用的模型,提供一行代码运行、用自有数据微调,以及用 Cog 打包部署自定义模型,按实际算力计费。
同分类
Cerebras
以晶圆级引擎做 AI 推理的芯片与云服务公司,官网称 CS-4 推理速度最高可达 GPU 系统 30 倍,提供与 OpenAI API 兼容的接口,按 token 计费。
同分类

潞晨科技
AI 大模型开发部署平台企业,官方称以自研 Colossal-AI 覆盖训练、微调、推理与部署全链路,潞晨云提供按量计费的 GPU 算力与 Token 工厂式 MaaS 服务。
同分类