
OpenDataLab
其他上海人工智能实验室推出的开放数据平台,官方称面向国产大模型提供高质量开源数据集,支持数据集检索与下载,并配套数据标注与治理工具及开源社区能力。
开放数据集数据标注模型训练
月访问量3.0 万↓25.2%
全球排名#963,312
月访问量为第三方平台估算,仅供参考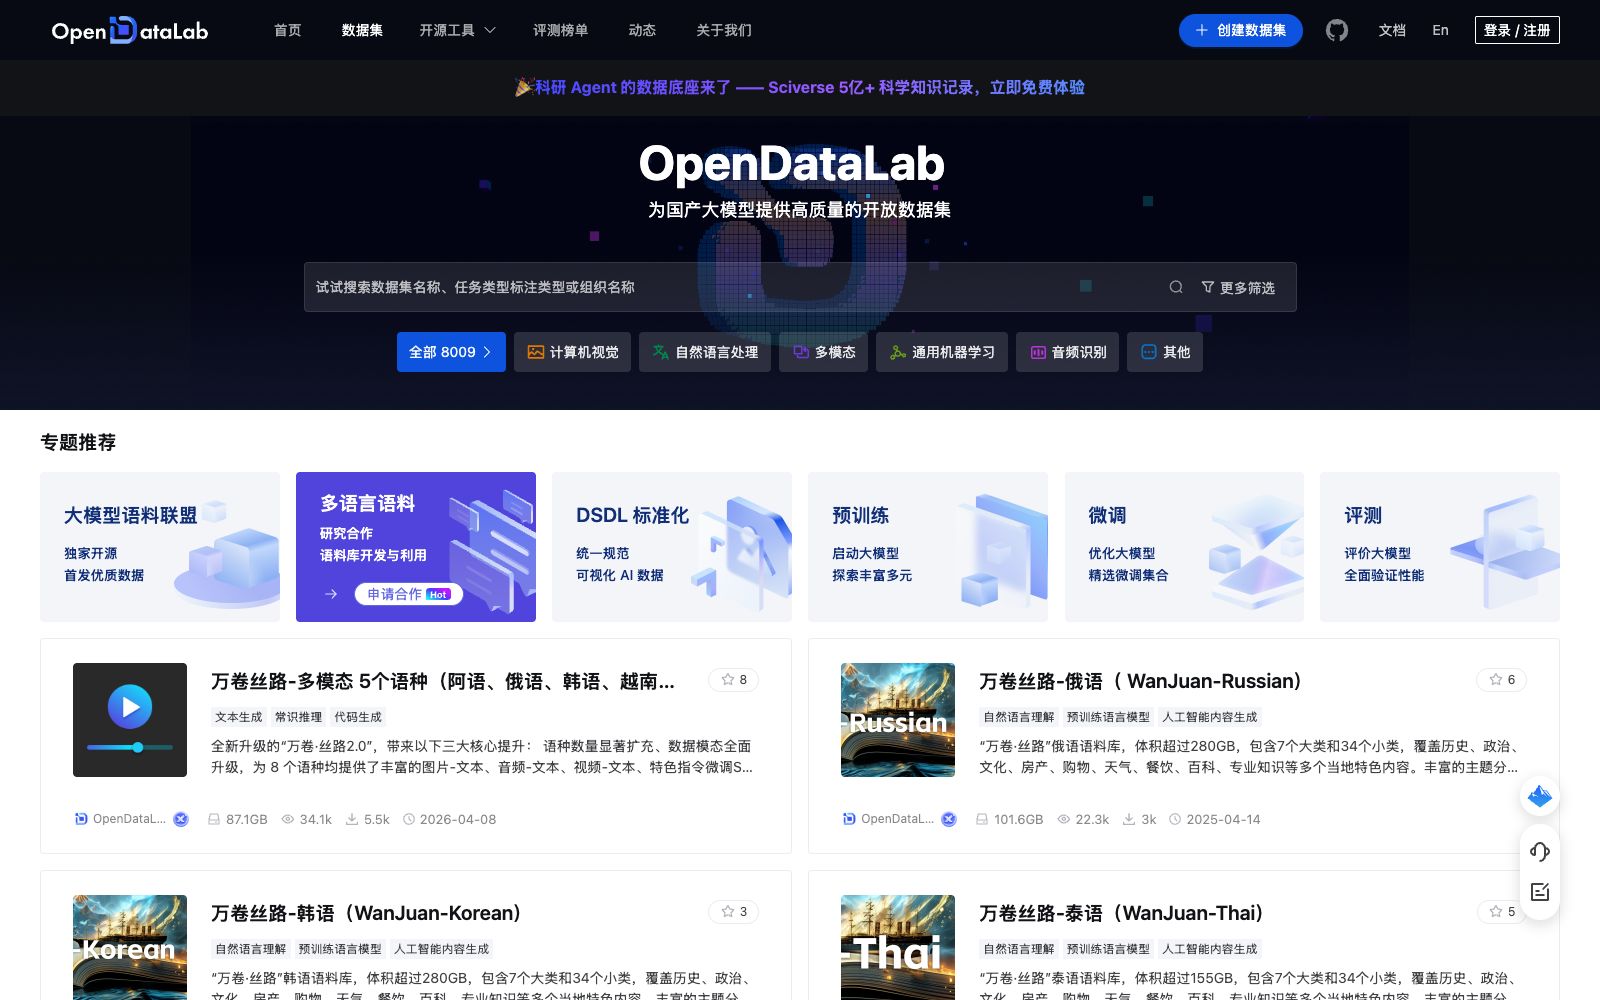
Deep Dive
更新于 2026-11-04详细介绍
快速了解
核心摘要- 是什么
- 上海人工智能实验室推出的开放数据集平台,为国产大模型提供高质量数据集与配套工具
- 核心能力
- 开放数据集、数据集检索、数据标注工具、数据治理、开源社区、多模态覆盖
- 使用方式
- 网页端检索并下载数据集,配合标注与治理工具使用
OpenDataLab 官方定位为「为国产大模型提供高质量的开放数据集」,由上海人工智能实验室推出。它解决的是模型训练中最耗资源的一环:数据集从哪来、质量如何、如何标注与治理。平台把数据集检索下载与配套工具放在一起,并围绕开源社区组织内容,为研究者提供可复用的数据基础。
核心能力
- 开放数据集:官方称面向国产大模型提供高质量开放数据集,覆盖多种模态与任务类型。
- 数据集检索:官方提供数据集入口与检索能力,便于按任务与模态查找可用数据。
- 数据标注工具:平台配套标注工具链,用于把原始数据加工成可训练的数据集。
- 数据治理:围绕数据质量校验与后结构化处理提供配套能力,提升数据可用性。
- 开源社区:官方以开源社区形式组织数据贡献与交流,扩大数据集覆盖面。官方称平台把数据集检索下载与配套工具放在一起,围绕开源社区组织内容。
- 多模态覆盖:数据集类型覆盖文本、图像等常见模态,满足不同训练任务需求。官方称平台由上海人工智能实验室推出,定位为为国产大模型提供高质量的开放数据集。
适合谁
- 大模型训练团队:寻找可直接使用或二次加工的中文数据集。
- 高校与科研课题组:用公开数据集做可复现的对比实验。
- 需要做数据标注的项目组:参考其标注工具链搭建自有标注流程。
- 数据工程从业者:了解数据集治理与质量控制的做法。官方称目标是让研究者获得可复用的数据基础。
- 数据集贡献者:把整理好的数据集发布到平台,获取使用反馈。官方称平台要解决的是模型训练中最耗资源的一环,即数据集从哪来、质量如何、如何标注与治理。
使用建议
- 下载前逐一确认数据集的许可协议,不同数据集的商用与再分发条件差别很大。
- 注意数据集的采集时间与领域分布,训练前先做抽样检查,避免领域偏移。
- 涉及个人信息或版权内容的数据集要确认合规来源,谨慎用于商用模型训练。
- 自建标注流程时先做小批量试标,统一标注口径后再扩大规模。
- 为数据集建立版本与来源记录,实验结论才具备可复现性。此外,这类偏基础设施与社区型的工具,价值往往在使用一段时间后才显现:早期多花点时间熟悉它的数据结构和接口约定,后续接入自有工作流的成本会明显下降。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
OpenDataLab 每月约有 3.0 万次访问,在「其他」150 个同类工具中排第 113 位。全球排名第 963,312 位(新兴站点),近一个月流量下降 25.2%。
月访问量
3.0万
较上月 -25.2%较3月前 -41.1%
跳出率
53.5%
只看一页就离开,越低越好
平均时长
00:47
每次访问的平均停留
次均页数
3.54页
每次访问浏览的页面数
近 12 个月当月 3.0 万
2.8 万
3.2 万
3.9 万
4.3 万
2.8 万
4.0 万
3.7 万
4.4 万
5.0 万
4.3 万
4.0 万
3.0 万
10月11月12月1月2月3月4月5月6月7月8月9月
用户地区
访客所在国家 / 地区- 中国53.0%
- 美国10.2%
- 中国香港5.9%
- 中国台湾4.1%
- 韩国2.7%
流量来源
访客从哪里进来- 搜索引擎43.6%
- 直接访问34.7%
- 外链引荐17.6%
- 社交媒体1.6%
- 邮件0.6%
- 其他1.9%
「其他」内排名低于中位数 76%
第113名
共 150 个同类工具
本工具
3.0 万
中位数
12.4 万
2026-09 数据 · 更新于 2026-11-01第三方平台估算,仅供参考
相似工具
面向开发者与企业的计算机视觉平台,覆盖数据管理、标注、训练到云端与边缘部署,官方称超 100 万工程师在用,配套 Inference、supervision 等开源库。
同标签 · 数据标注 / 模型训练
279 万/月