腾讯混元AI视频
视频与动画腾讯混元推出的文生视频能力,官方称其开源视频模型参数规模与性能居开源前列,支持文生视频、原生切镜与连续动作,并提供语音驱动的数字人形象与自动配音能力。
详细介绍
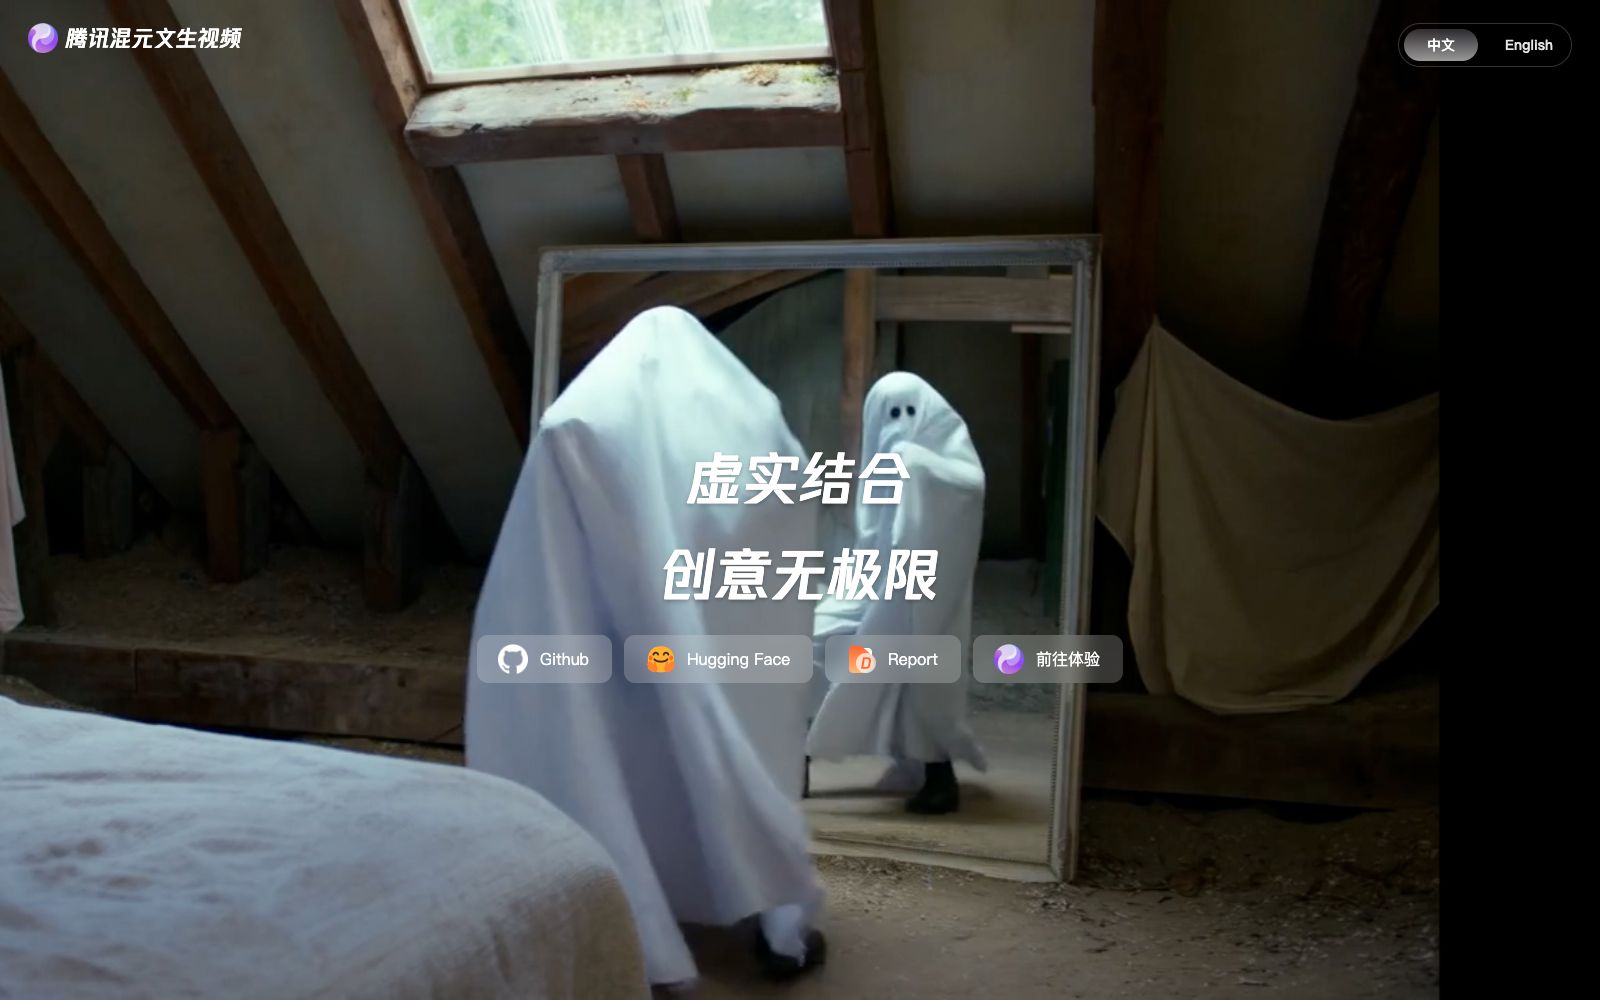
腾讯混元AI视频是腾讯混元体系在视频方向的能力集合,官网重点介绍文生视频模型与语音驱动的数字人能力。官方称该模型是目前开源模型中参数最多、性能最强的文生视频大模型,并强调物理准确性与镜头一致性。除纯生成外,平台还提供唇形与表情驱动能力,可用于数字人口播类视频的制作,把形象与声音一起生成。
核心能力
- 文生视频生成:官方称模型可生成具有较强物理准确性与一致性镜头的视频,并能在真实与虚拟风格之间自由转换。
- 原生切镜能力:官方称支持自然衔接的场景切换,可在一次生成中完成多镜头叙事,减少后期拼接与对轨的工作量。
- 连续动作与运镜:官方称可一次性完成多个连续动作,并具备导演级运镜能力,实现艺术镜头之间的无缝衔接。
- 物理遵从与概念泛化:官方称生成的运动符合物理定律,同时支持把不同概念自由组合,拓展创意表达的空间。
- 国风与东方美学:官方展示了敦煌雕塑、国风等风格示例,说明在东方文化题材的生成上有针对性的优化。
- 语音与表情驱动:提供语音驱动、动作与表情驱动能力,官方称能准确跟随复杂姿态并保持人物身份一致,还支持端到端自动配音。
适合谁
- 短视频与广告创作者:需要快速生成镜头素材,用于分镜验证、创意提案与投放测试。
- 影视与动画前期团队:用生成片段评估镜头语言与叙事节奏,降低前期试错的时间与成本。
- 数字人内容运营者:需要唇形与表情驱动的口播视频,用于账号内容的稳定更新。
- 技术团队与研究者:关注开源视频模型的参数规模、生成质量与可复现性,用于选型研究。
使用建议
- 提示词中明确镜头类型、动作顺序与光线氛围,官方示例显示这类描述能显著改善生成效果。
- 涉及人物形象或肖像的生成内容,公开传播与商用前需确认授权,避免肖像权与版权风险。
- 生成内容用于商业用途时,请以平台与模型许可条款为准,开源许可并不等于可无条件商用。
- 视频生成的计算成本较高,建议先用短片段验证提示词方向,再投入较长的生成任务。
- AI 视频生成目前仍以「短片段 + 后期拼接」为主流工作方式:单条生成时长有限,复杂叙事建议按分镜拆成多个片段生成,再用剪辑软件统一节奏与配乐。
相似工具
书生·筑梦
书生·筑梦(Vchitect)是上海人工智能实验室推出的视频生成模型,官方称Vchitect 2.0支持5至20秒生成、灵活宽高比与超分插帧,并具备图生视频能力。
同标签 · 开源模型 / 文生视频
SkyReels
SkyReels是昆仑万维推出的AI视频生成平台,围绕故事化叙事提供文生视频、图生视频与多模态参考生视频能力,官方称可同时生成画面与声音,并支持跨分镜的角色一致性与情节延续。
同标签 · 文生视频
HeyGen
AI 数字人视频平台,几分钟生成以你为主角的真人级口播视频,主打 Avatar V 角色一致性,支持多角度拍摄、精准口型同步、情感表达与一键多语言翻译。
同标签 · 数字人

Luma AI
Luma AI 是创意 AI 平台,旗下 Ray 与 Uni 系列视频模型支持文生视频与图生视频,Ray 3.2 强调逐帧可控的导演级运镜,并提供创意智能体处理端到端创作工作流。
同标签 · 文生视频
万兴天幕
万兴天幕是万兴科技推出的AI内容创作平台,官方称一句话即可生成视频、图片与音乐,覆盖文生视频、图生视频、视频续写、文生音乐与文生语音等模块,并支持镜头与情绪的精细控制。
同标签 · 文生视频
可灵 AI
快手推出的 AI 视频与图像生成平台,主打原生 4K 视频、动作控制、首尾帧与音画同步能力,支持超长视频分镜并开放开发者 API。
同标签 · 文生视频