fal.ai
图像生成与编辑面向开发者的生成式媒体推理平台,提供一千多个图像、视频、音频与3D 模型的统一 API,并支持按需 serverless GPU 与独占集群部署自建模型。
详细介绍
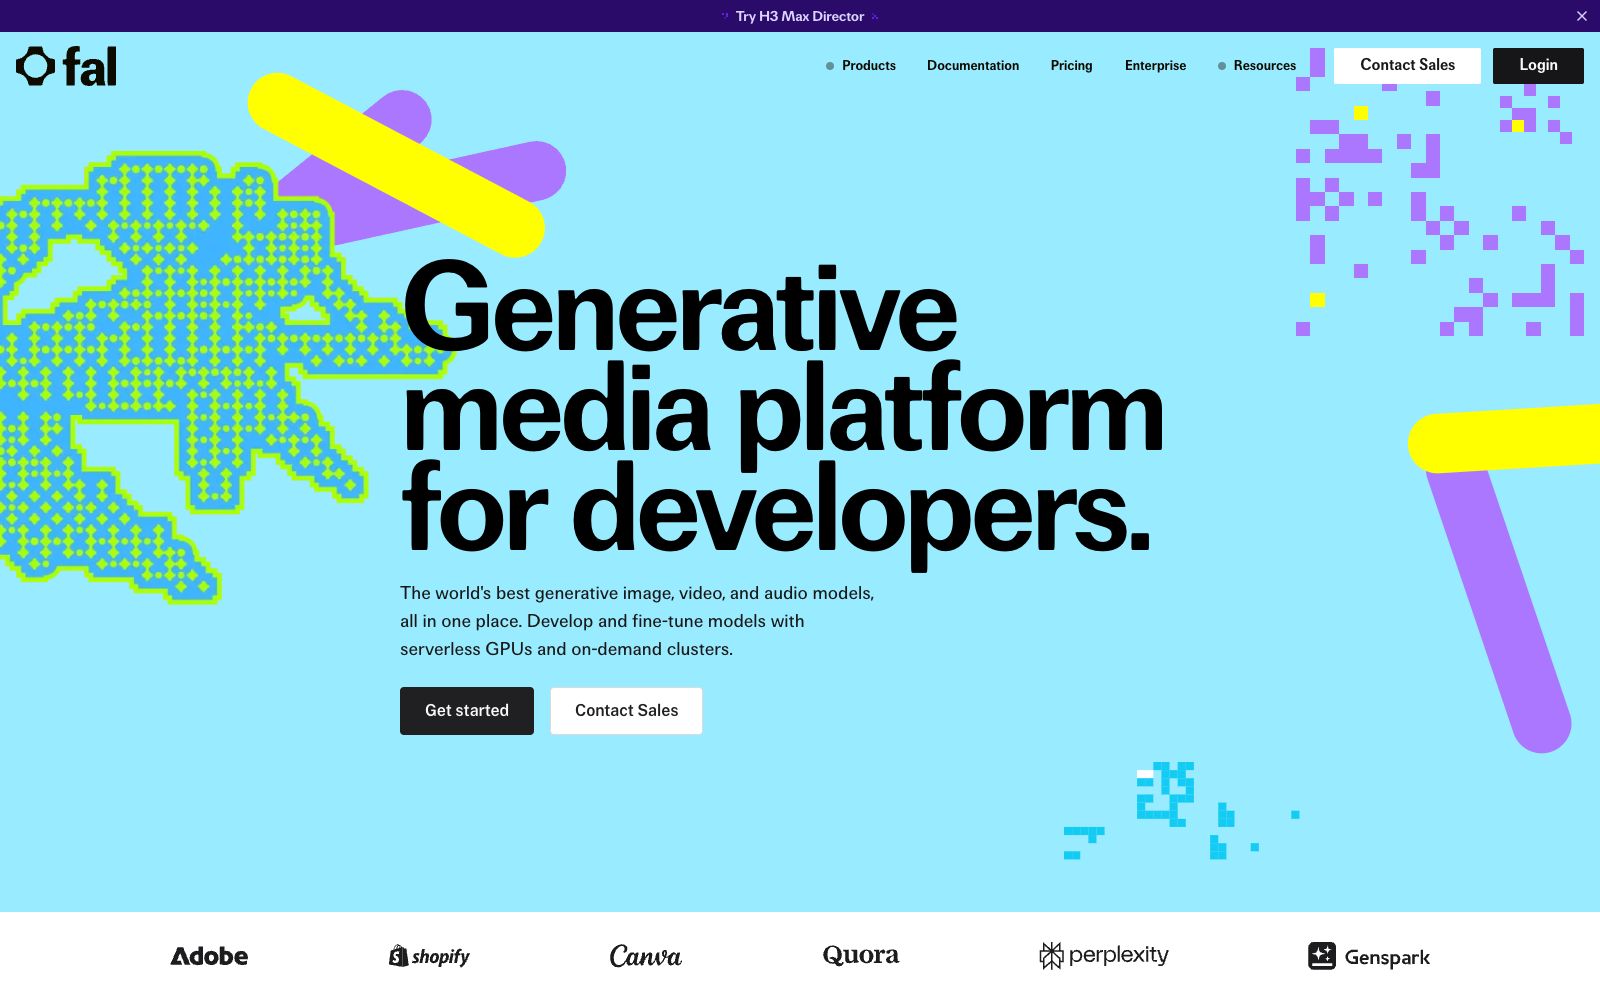
fal.ai 不是给终端用户点的图片工具,而是面向开发者的生成式媒体推理平台。官网首页主标题是「Generative media platform for developers.」,产品切成三块:模型库、serverless GPU、独占集群。它解决的是——产品团队想在自己应用里接入图像、视频、音频或 3D 生成能力,但每个模型背后是不同团队、不同部署方式、不同计费口径。fal 的做法是收拢成一个 API 与一套账单,官网写「Choose from 1,000+ production ready image, video, audio and 3D models」。
核心能力
- 统一模型 API:官网称「All accessible with a simple API. No fine-tuning or setup needed — just call and go」。
- fal serverless:官网描述为「globally distributed serverless engine」,无需配置 GPU、无冷启动,「Scale from zero to thousands of GPUs instantly」。
- fal compute:提供 H100、H200、B200 等型号按需算力,首页标注「starting at $1.89」。
- 独占集群:面向前沿研究实验室,可保证性能地微调、训练或运行自定义模型。
- 推理引擎与可观测性:官网称自有 Inference Engine 面向扩散模型优化,配一体化运行、部署与监控工具链,支持从原型到日均上亿次调用。
适合谁
- 在产品里内嵌 AI 生成功能的创业团队:不想自己运维 GPU,也不想一家家对接模型厂商。
- 需要同时评估多家视频与图像模型的算法工程师:一个接口切换模型字符串即可横向比价。
- 有稳定调用量、需要预留自有模型的团队:可在 serverless 与独占集群之间迁移。
- 独立开发者与中小团队:可以先用模型 API 跑通原型,不必一开始买集群。
使用建议
- 先确认模型是否在架、以及计费单位(图像按张、视频按秒或按 token),定价页给了「每 1 美元可用多少单位」的估算,方便换算成本。
- serverless GPU 与 model API 是两条不同计费路径:部署自己的微调模型走 compute/hour,直接调模型走按次计费,选错会让账单差一个数量级。
- 官网提到从原型到日均 100M+ 调用的扩展能力,但同样提示分辨率、时长与质量会影响最终成本,上线前按真实参数压测。
- 涉及第三方模型时,商用授权与合规责任归属要看该模型自己的许可条款,fal 是托管通道,不替你判断上游模型的可用性。
- 定价与模型上下架变化较快,具体单价以下单当时的 Pricing 页为准。
相似工具
Replicate
运行与部署开源 AI 模型的云平台,官方称社区已发布数千个可直接调用的模型,提供一行代码运行、用自有数据微调,以及用 Cog 打包部署自定义模型,按实际算力计费。
同标签 · 模型API
Ideogram
生成式媒体平台,把创意工作区、统一 API 与 MCP 智能体接入放在一起,官方主打文字可读性与提示词还原度,图像与视频模型共用同一套接口。
同标签 · 模型API
RunPod
面向开发者的 AI 云平台,提供按需 GPU、无服务器端点、多节点集群与模型部署四类形态,覆盖推理、Agent、微调与计算密集任务,并公开各型号 GPU 的单价。
内容相近

派欧云
分布式云计算服务商,官方称提供大模型与图像视频模型 API、Agent 沙箱与托管、GPU 容器实例与 Spot 算力,兼容 OpenAI 与 Anthropic 接口标准。
同标签 · 模型API
Getimg.ai
集成主流模型的 AI 创作工作台,可在一个空间里生成与编辑图像、视频、音乐与语音,官网主打无需研究模型与复杂配置即可开工,并提供 API。
同分类
imgsys
fal.ai 推出的生成图像模型竞技场,用同一提示词对比不同模型出图,按用户投票给出人气排名并标注样本量,覆盖商业与社区模型,可直接在线试玩。
同分类