返回首页


标贝科技
语音生成与转换标贝科技是AI数据基础设施服务商,围绕语音、视觉、文本与大模型场景,提供数据采集、标注到数据集交付的全流程服务,并具备ASR、TTS与音色克隆等语音模型能力。
数据标注语音数据大模型语料
月访问量1.3 万
全球排名#1,405,697
月访问量为第三方平台估算,仅供参考界面预览
详细介绍
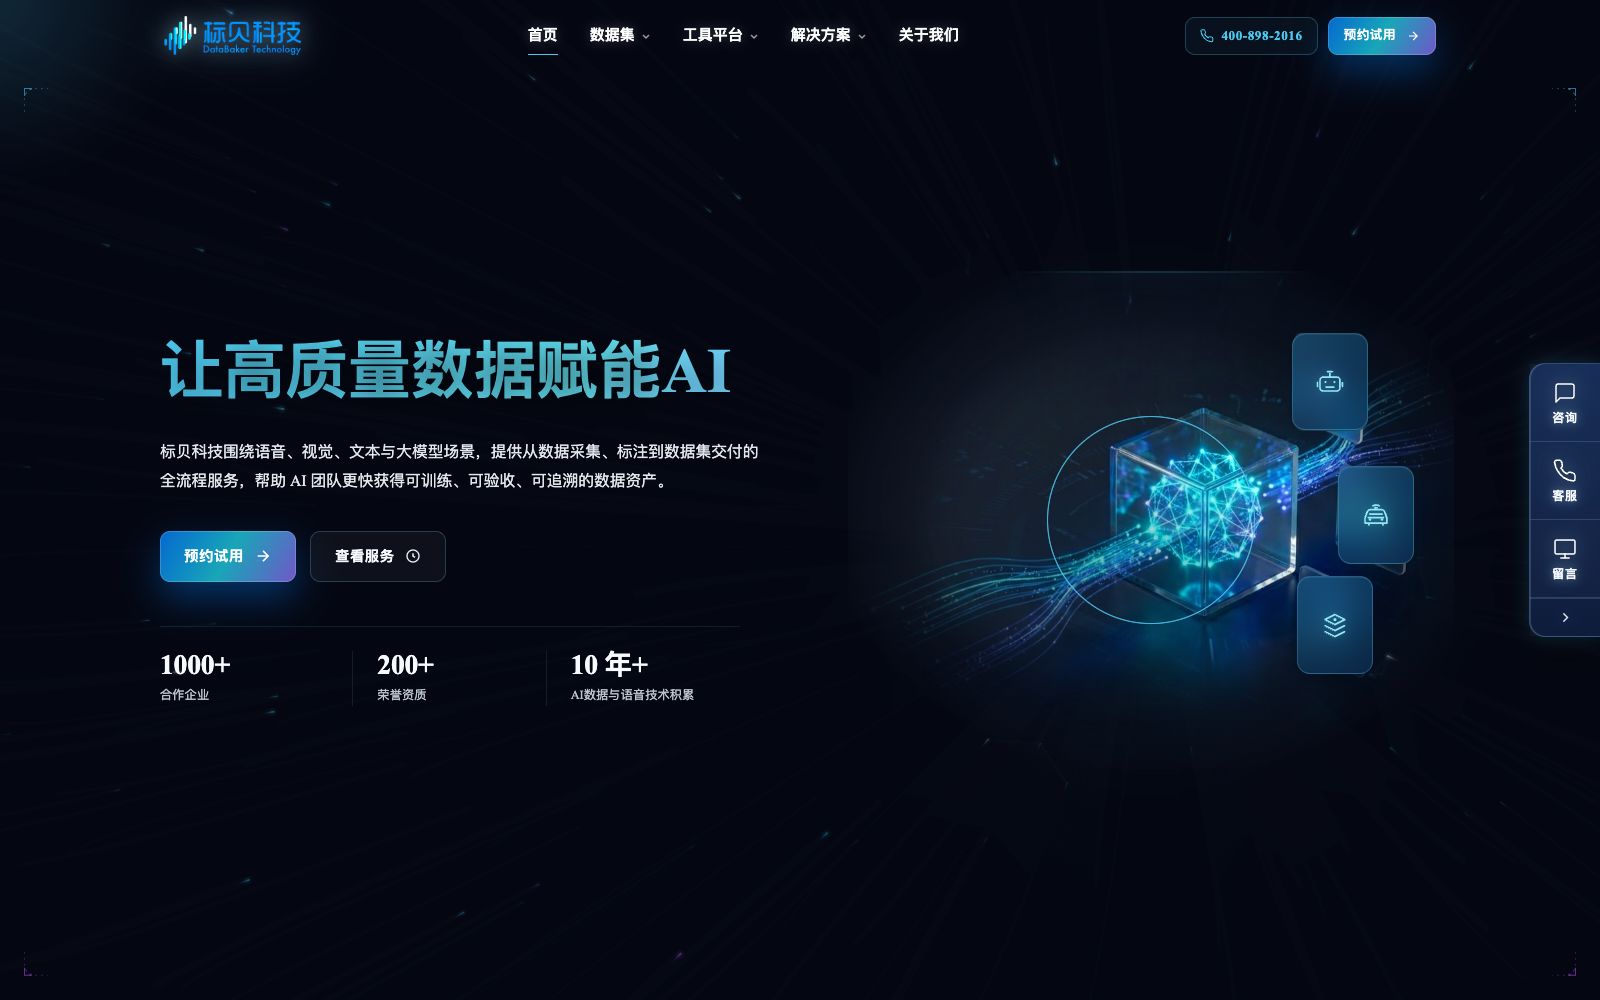
标贝科技是一家以AI数据基础设施为核心的公司,官网把自身业务概括为让高质量数据赋能AI。它围绕语音、视觉、文本与大模型场景,提供从数据采集、标注到数据集交付的全流程服务。与单纯售卖成品数据集的做法不同,它把采集、标注、质检与验收串成一条可追溯的链路,官方称已与一千家以上企业合作。
核心能力
- 数据采集服务:围绕语音、图像、视频、文本等需求建立从样本设计到采集执行的标准化流程,官方称支持人群与场景配额设计、多端任务管理与数据脱敏。
- 数据标注服务:覆盖分类、转写、分割、框选、偏好排序与大模型评测等任务,通过多轮质检与抽检机制形成可追溯的质检链路。
- 成品数据集:提供语音识别、语音合成、图像、视频、文本与大模型训练数据等多类即开即用的数据集,并支持授权交付与行业定制扩展。
- 大模型数据服务:覆盖预训练语料、指令微调语料、偏好对齐数据与安全评测,官方称可提供有害性标注与多模型答案比对等数据生产环节。
- 语音模型能力:官网展示ASR、TTS与音色克隆三类任务,其中音色克隆强调授权样本、风格样本与安全评测集的构建,用于降低上线风险。
- 合规与可追溯:官方称采集授权、隐私脱敏、过程留痕与质量抽检共同构成可验收的数据链路,适合对数据来源合规有要求的团队。
适合谁
- 训练自研语音识别或语音合成模型的团队:需要成规模、多口音、多语种的语料与配套评测集。
- 需要为垂直行业补充场景数据的产品团队:例如医疗、汽车、客服等细分领域,通用标准数据集往往覆盖不足。
- 做大模型微调与对齐的团队:需要指令微调语料、偏好排序数据,以及安全与价值观对齐所需的标注资源。
- 数据合规要求较高的机构:需要采集授权、脱敏与过程留痕都能被验收和审计的数据供应链。
使用建议
- 需求沟通时先把标注规范与验收标准写清楚,试标通过后再批量生产,返修成本通常主要来自规范不一致。
- 涉及个人信息或人脸、声纹等敏感数据时,务必确认采集授权与脱敏方案的覆盖范围,避免后续合规风险。
- 定制数据集的价值集中在难例与长尾场景,建议在合同中约定难例占比与抽检比例,而不是只看总条数。
- 音色克隆相关数据须特别确认声音权利人的书面授权,未经授权的声音复制存在明确的侵权风险。
- 交付前要求提供样本统计与试听试看通道,先小规模验证数据质量,再决定是否扩大交付规模。
相似工具
OpenDataLab
上海人工智能实验室推出的开放数据平台,官方称面向国产大模型提供高质量开源数据集,支持数据集检索与下载,并配套数据标注与治理工具及开源社区能力。
同标签 · 数据标注
豆包语音
火山引擎的语音大模型产品线,覆盖语音合成、声音复刻、语音识别、实时语音与音频生成等能力,官方称提供 400+ 音色、30+ 语种,面向企业支持 API 与 SDK 接入。
同分类
Roboflow
面向开发者与企业的计算机视觉平台,覆盖数据管理、标注、训练到云端与边缘部署,官方称超 100 万工程师在用,配套 Inference、supervision 等开源库。
同标签 · 数据标注
FlagEval天秤
智源研究院的大模型评测体系与开放平台,官方称覆盖语言、多模态、计算机视觉与语音四类评测场景,提供排行榜、大模型角斗场与自动加人工结合的评测方法与工具集。
内容相近
悟声 AI
超拟真 AI 语音合成与瞬时克隆平台(原 Reecho 睿声),官方称自研文生语音模型支持 30+ 语言与方言,最短 3 秒样本即可克隆声音,并提供声音市场与低延迟 API。
同分类
🤖
Forefront
面向开发者的开源模型微调与部署平台,支持数据集管理、效果评估与无服务器推理,强调数据主权与模型权重归属;注意其官网近期无法访问,服务状态需先确认。
内容相近