Cleanlab
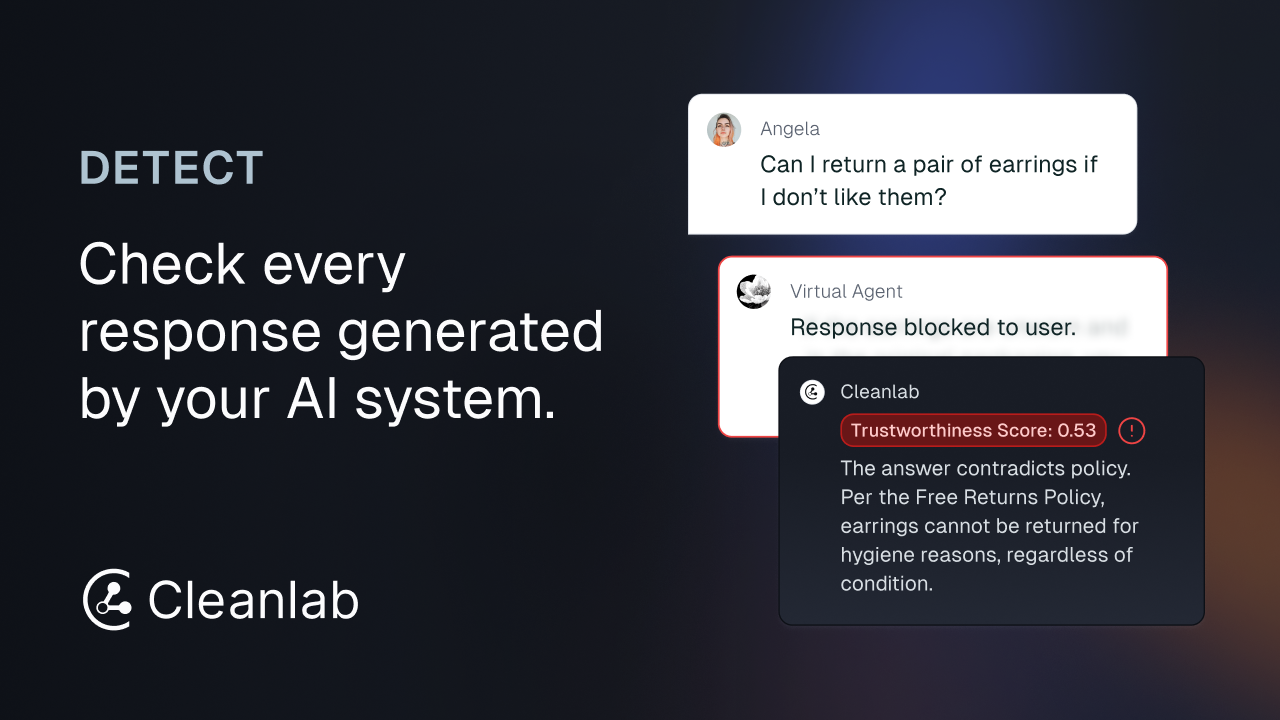
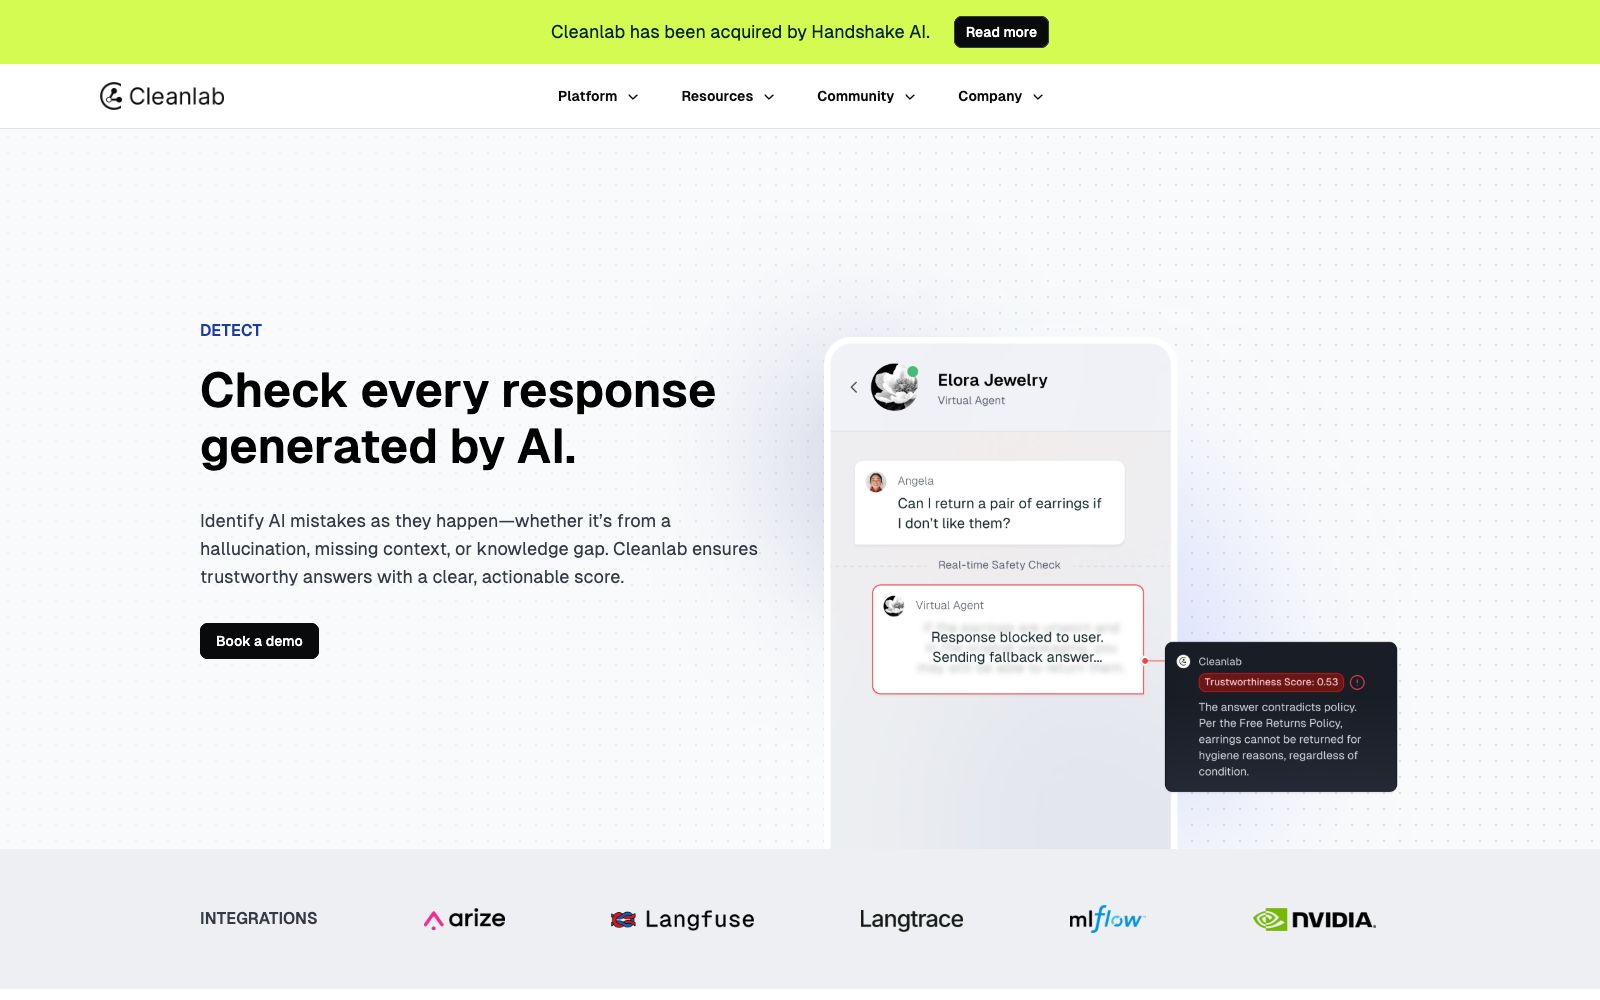
部署/运维/可观测Cleanlab 实时给 AI 回复打可信度分,识别幻觉、用错上下文与知识盲区,用单一指标决定何时拦截或转人工,守护问答与客服系统的输出质量。
界面预览
详细介绍
快速了解
核心摘要- 是什么
- 专为 AI 回复不可信设计的检测产品 Detect,对每一条模型输出实时打分并判断是否可信
- 核心能力
- 幻觉检测、错误上下文识别、知识盲区标记、单一可信度分、分级升级、易于集成
- 使用方式
- 作为 AI 系统的质检环节接入,先小流量验证分数与人工判断的一致性再放开
Cleanlab 的 Detect 产品专为「AI 回复不可信」这个生产难题设计:对每一条模型输出实时打分,判断它是否可信。官方把问题拆成三类——幻觉、用错上下文、知识缺口——而这三类恰恰是再精心设计的 LLM、检索系统或知识库也难以完全避免的。它要解决的并不是「让模型更聪明」,而是「在合适时机拦截不可信输出」,为已经上线的 AI 系统加上一道可靠的质检关卡。它的工作方式是对输出做实时评分而不是事后抽查,因此可以嵌进在线链路,在回答到达用户之前完成风险判断。
核心能力
- 幻觉检测:识别模型凭空编造答案的情况,官方称其检测能力经过验证,在同类方案中表现最好。
- 错误上下文识别:判断回答是否引用了不相关或错误的资料,避免「答非所问却言之凿凿」的输出流到用户面前。
- 知识盲区标记:识别问题超出系统知识范围的情况,提示该转人工或补充资料,而不是硬着头皮回答。
- 单一可信度分:输出一个源自真实运维验证的指标,把复杂判断收敛成一个分数,便于你据此设定拦截阈值。
- 分级升级:按分数决定何时把回答转给人工、触发兜底流程或直接拦截,形成「低风险放行、高风险升级」的分流机制。
- 易于集成:面向已有的 AI 系统做旁路接入,官方提供多种 Integrations,不必改动核心链路即可上线。
适合谁
已经上线 AI 问答、客服或检索增强(RAG)系统的团队,尤其是错误回答代价高、必须有可靠人工介入机制的行业。金融、医疗、法务这类对准确性敏感的领域,以及面向 C 端、答错会影响口碑的产品,收益最明显。如果你的产品已经出现过「答错被截图传播」这类事故,它就是值得优先考虑的护栏。
注意事项
- 分数是「分流信号」而非「正确性断言」:它提示风险高低,但不能保证回答绝对正确,拦截后的补救要靠自己的系统承接。
- 建议先用历史数据标定阈值,观察在什么分数段误判率可接受,再决定哪些区间转人工,别一上来就全量拦截。
- 官方核心能力以 API 形式提供,调用前需评估数据外发是否符合你的隐私与合规要求;数据敏感的场景先确认处理政策。
- 它属于检测层而非修复层,幻觉与错配问题仍需结合检索质量、提示词设计等上游手段一起治理。
使用建议
把它当作 AI 系统的「质检工位」而不是最终裁判。先小流量接入,用一批已标注的坏样本验证分数与人工判断的一致性,再逐步放开拦截与升级策略;上线后持续用真实误判样本回灌,校准阈值。另外可以把它与人工质检流程打通,让低分回答自动进入复核队列,逐步把团队的判断经验沉淀成可执行的规则。注意别让拦截率过高拖累用户体验,平衡「防错」与「可用」两端。
产品方可认领本页:认领后标注「官方认领」,信息变更走优先通道。免费,不影响排序。
认领这条收录 →访问量
Cleanlab 近一个月流量下降 15.7%,月访问量约 4,739,在「部署/运维/可观测」15 个同类工具中排第 14 位。全球排名第 5,822,769 位(新兴站点)。
用户地区
访客所在国家 / 地区- 美国45.0%
- 印度17.4%
- 印度尼西亚6.6%
- 韩国5.9%
- 土耳其5.0%
流量来源
访客从哪里进来- 直接访问38.8%
- 搜索引擎35.3%
- 外链引荐11.8%
- 社交媒体5.7%
- 展示广告2.7%
- 邮件2.6%
- 其他3.1%
相似工具
面向企业与教育机构的文本真实性平台,提供 AI 检测、查重、代码抄袭与 AI 视频检测,官方称支持 30 多种语言、误报率 0.03%,可通过 API 与多种 LMS 集成。
同标签 · API
Exa 是面向 AI Agent 的搜索 API,一个端点提供实时网页数据、深度研究与结构化内容,返回带高亮且 token 高效,官方称 50 万+ 开发者使用,可免费试用
同标签 · API