BentoML
其他BentoML 是面向生产环境的模型推理平台,支持任意模型部署、定制推理优化与弹性伸缩,并开源模型服务框架,主打速度与可控性。
详细介绍
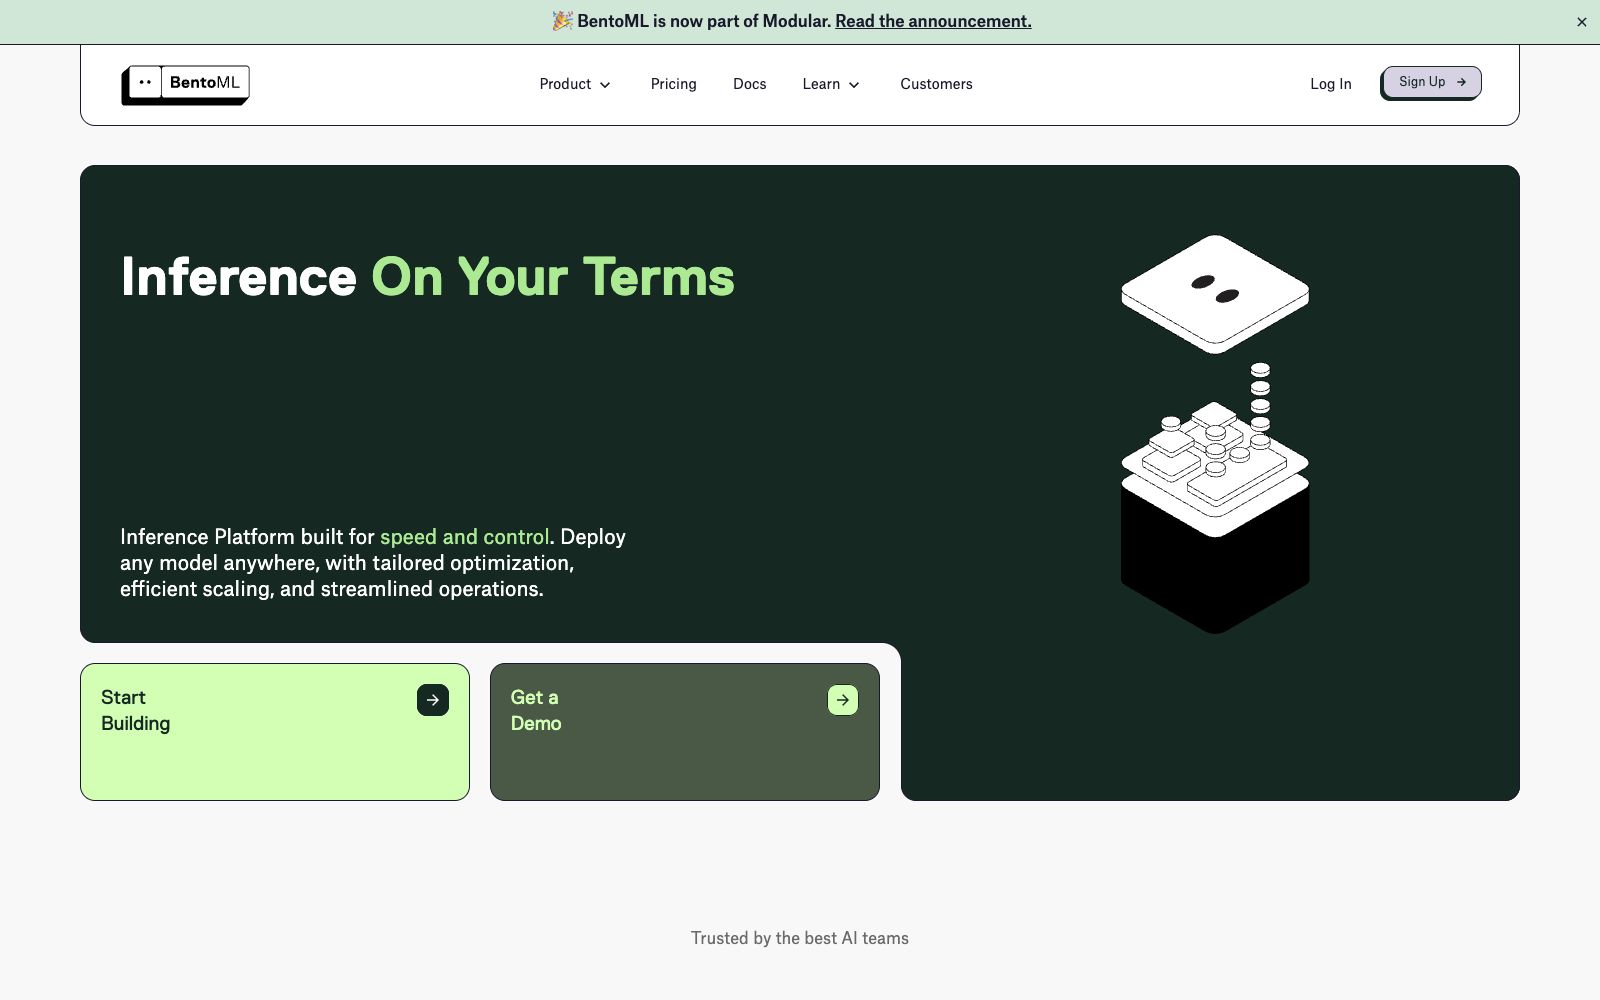
BentoML 是一个为生产环境打造的模型推理平台,官网定位为「按你的条件运行推理(Inference On Your Terms)」——既提供托管平台,也维护广受欢迎的开源模型服务框架。它把模型打包、部署、扩缩容与运维串成一条可控的链路,面向需要把 AI/ML 模型稳定、高效地跑在线上系统的团队。官网称其被众多顶尖 AI 团队信任。
核心能力
- 任意模型部署:提供开源模型目录一键部署,也支持统一框架打包任意架构、框架或模态的自定义模型。
- 推理管理:覆盖部署自动化与 CI/CD、全面可观测性、细粒度访问控制、资源与配额跟踪与性能调优。
- 高效扩缩容:自带计算引擎做跨区弹性伸缩、冷启动加速、伸缩至零与多云算力编排。
- 算力编排:支持自带云、本地 Kubernetes 与 Bento Cloud,官方称可免采购使用前沿 GPU 硬件。
- 开源框架:BentoML 开源部分是最灵活的生产级模型服务与自定义推理管线方案之一。
- LLM 网关:官网列出 LLM Gateway 等能力,统一接入与管理大模型流量。
适合谁
- 需要把训练好的模型稳定上线、又想保留部署控制权的工程团队。
- 使用多种开源模型、希望统一框架打包与服务的算法工程师。
- 关注推理成本与延迟、需要弹性伸缩与可观测性的中大型组织。
- 倾向自托管、不想被单一云厂商锁定的基础设施负责人。
- 需要把推理接入既有 CI/CD 与监控体系的平台团队。
使用建议
- 先用开源 BentoML 框架跑通本地打包与部署,再评估是否上 Bento Cloud。
- 生产环境务必开启可观测性与访问控制,按官网文档配置配额与审计。
- 弹性伸缩与 GPU 编排涉及成本,长期运行前先用冷启动与缩容策略测算预算。
- 官方产品能力与定价会演进,正式选型前再核一次当前支持的部署形态。
- 多模型统一服务时注意版本与依赖隔离,避免互相干扰。 上手时建议先用免费额度把核心工作流跑通一遍,确认输出质量符合预期后,再评估是否值得升级到付费方案。
相似工具
DeepSeek 深度求索
DeepSeek 是深度求索的大模型系列,官方开源 V4、R1 等前沿模型,提供网页版、手机应用与开放 API,主打高性价比与原生多模态视觉理解能力。
同标签 · 推理 / 开源
算家云
算家云是高性能 GPU 算力租赁与 AI 训练推理平台,提供 A100、4090、5090 等显卡按需租用,上百种开源模型一键启动,官网称 4090 低至 1.24 元/卡时。
同标签 · 模型部署
Together AI
Together AI 是 AI 原生云平台,提供开源模型推理、微调与 GPU 集群,OpenAI 兼容接口迁移方便,官方称推理快 2 倍、成本低 60%、预训练快 90%。
同标签 · 推理
RunPod
面向开发者的 AI 云平台,提供按需 GPU、无服务器端点、多节点集群与模型部署四类形态,覆盖推理、Agent、微调与计算密集任务,并公开各型号 GPU 的单价。
同标签 · 模型部署
Latitude
Latitude 是开源的 AI Agent 可观测与监控平台,追踪生产轨迹、聚类失败模式并向编码 Agent 派发修复任务,官方称兼容 OTEL 并支持自定义信号。
同标签 · 开源
LangChain
LangChain 是构建大模型应用的主流开源框架,配 LangSmith Engine 覆盖 Agent 的构建、测试、部署与监控全周期,掌控模型、上下文与执行框架,被 700
同标签 · 开源